同一个 AI,换个工具就变了?
把多框架强化学习讲透:从模型、工具循环和精确 token 记录,到小模型多框架训练的收益与边界。含原站全部 61 张图与 24 段真实操作录屏。
阅读指南(先看这三条)
1. 下文所有数字均为原作者报告,本文未独立重跑训练;实现状态有日期边界(原文 2026 年 10 月 1 日快照),复现请核对官方当前文档。
2. 网页顶部动画里的计数器只是演示,不是实验总量;英文原图后紧跟中文解释。
3. 可操作部分配有真实浏览器录屏(无声),点播放即可看;视频较多,页面采用按需加载,打开视频才下载。
开篇
# 同一个 AI,换个工具就变了?把多框架强化学习讲透
你给 AI 一道题:读一份数据,写代码,计算结果,再把答案交出来。
同一个模型,放进一个工具里,可能先列计划、检查文件、写脚本、运行测试,最后完成任务。换到另一个工具里,它可能反复调用错误的命令,或者还没检查答案就宣布完成。
这不一定是模型“今天发挥不好”。模型外面的软件,也在决定它能看见什么、能做什么、如何从错误中恢复,以及什么时候必须停下来。
FineEnvs 的这篇交互文章研究的,正是这个容易被参数规模和排行榜掩盖的问题:能否让一个小模型,在多种真实的智能体运行框架中接受强化学习,从而学会跨框架做事?
先给出结果和边界。作者报告,LFM2.5-2.6B 在四种框架上的平均测试准确率,从约 42% 提升到约 54%;在训练前后都能做对的任务上,多框架训练后的工具调用数减少约 31%。但它与只在 OpenCode 中训练的模型,训练终点准确率只相差 1.9 个百分点。每种设置只运行一次,作者认为这个小差距仍在噪声范围内。
因此,本文值得看的是完整的方法、跨框架的表现与效率,以及失败实验暴露出来的工程问题。它没有证明“多框架永远更好”,也没有证明小模型已经解决所有编程任务。
本文根据原网页、同一版本的公开源码和数据重写。下文数字均为作者报告,未独立重跑训练。原网页图形原样展示,英文图后紧接中文解释;可操作部分配有真实浏览器录屏。网页顶部动画里的计数器只是演示,不是实验总量。
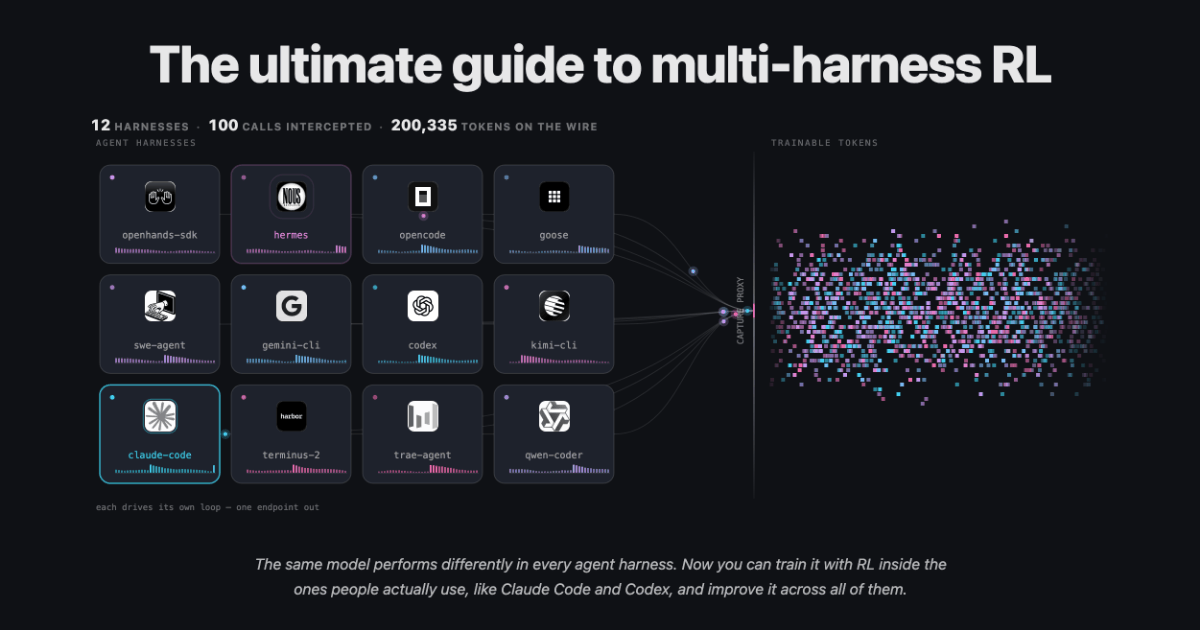
这张动态页眉把任务、工具与奖励串在一起。看它时抓住“做事—反馈—更新”这条链,别把滚动计数当成测量结果。
一、模型不是整个智能体:先分清五个角色
可以把模型理解为一个会根据上下文提出下一步行动的“大脑”。但大脑本身不会自动打开终端、管理文件,也不会凭空知道哪些工具可用。
Harness 就是包在模型外面的运行程序。本文译为“智能体运行框架”,保留英文,以免与训练框架混淆。它负责五件事:组织模型读到的上下文;告诉模型有哪些工具;把输出变成具体操作;把执行结果送回模型;决定重试、压缩上下文或停止。
智能体(agent) 是模型和这套运行程序共同组成的做事系统。模型权重相同,工具清单、系统提示、错误处理和上下文不同,最终表现就可能不同。
沙盒(sandbox) 是实际执行代码的隔离空间,里面有数据、文件、终端和运行环境。它相当于做实验的工作台,不是负责学习的老师。
强化学习环境(environment) 连接任务、执行过程和反馈,把可以学习的结果返回给训练器。本文中特指 OpenEnv 这层接口;Harbor 文档会把执行后端也称为 environment,阅读时要区分。
基准测试(benchmark) 是题库、作答规则和评分方式。换题库、超时上限、允许尝试次数或工具预算,都可能改变分数。
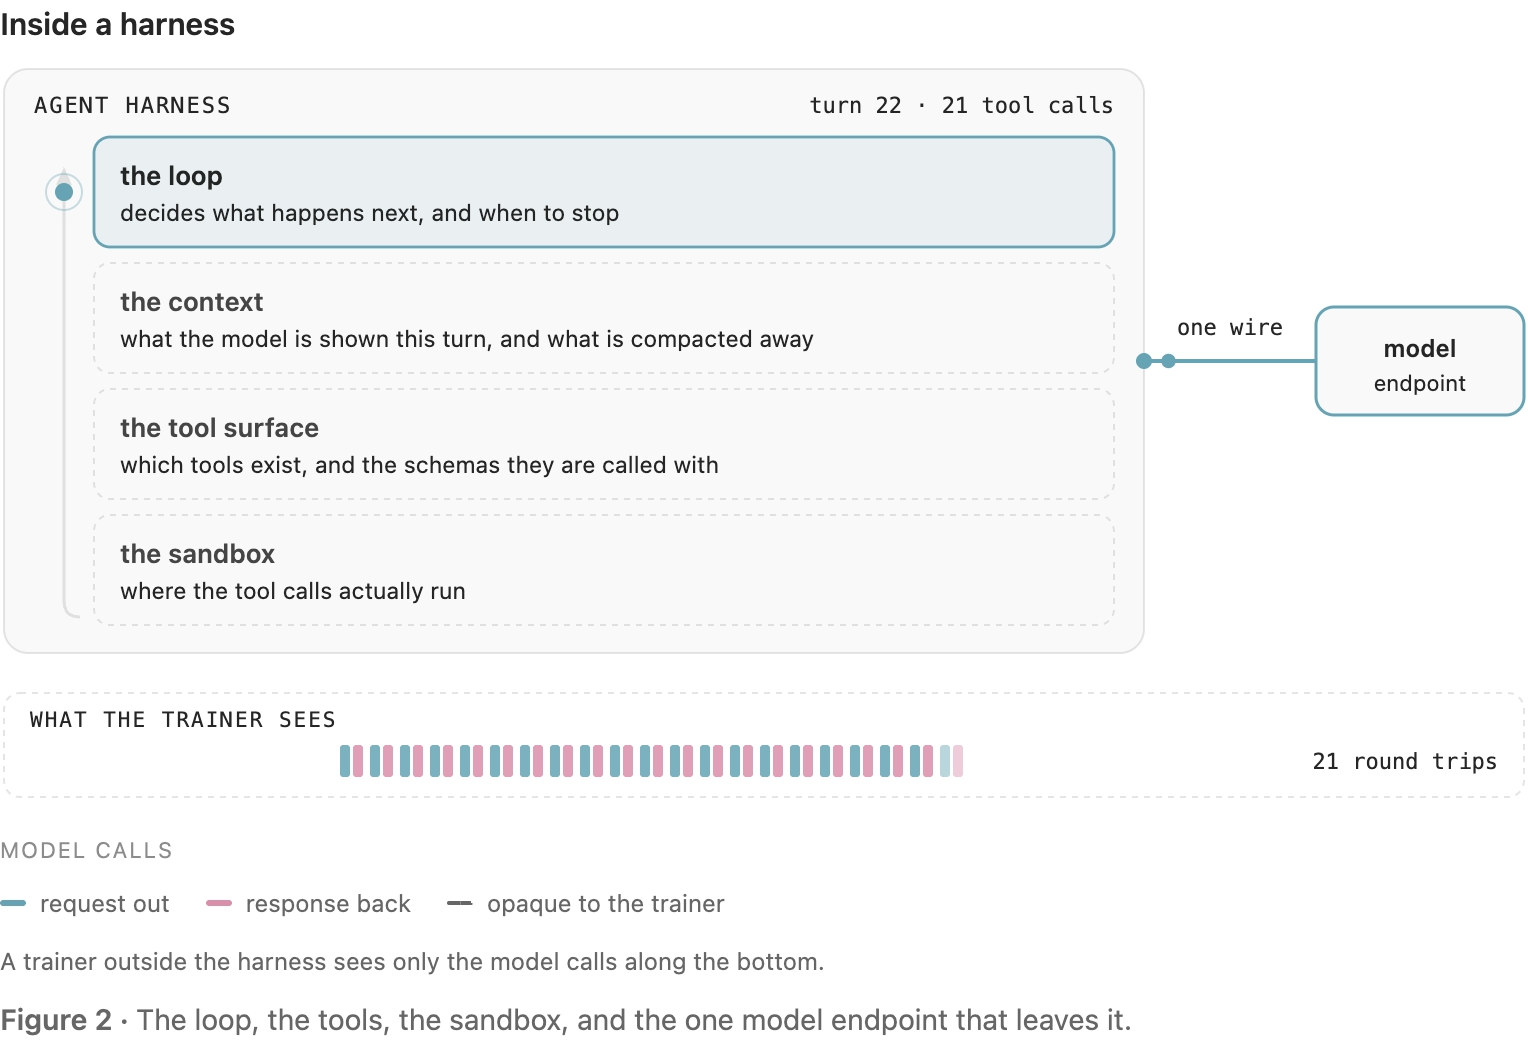
这张图拆开 harness 内部。重点看上下文与工具结果如何被重新组织,再送进模型:模型每一步读到的材料,是软件准备的,不是原封不动的世界。
模型与 harness 的关系,有点像学生和解题平台。平台是否提供计算器、是否展示之前的草稿、遇到错误是否允许继续,都会影响成绩。但这个类比只解释工作条件,不能把机器学习中的概率更新等同于人的理解。
原文引述 Joel Niklaus 的跨框架测量:同一个 GLM-5.2,在 SWE-bench Pro 上可以从某框架约 23% 到另一个约 52%;一个框架对一个模型排名靠前,对另一个模型却可能靠后。这是原文引述的外部测量,不能与下文 FineEnvs 自己的数据分析任务实验合并。
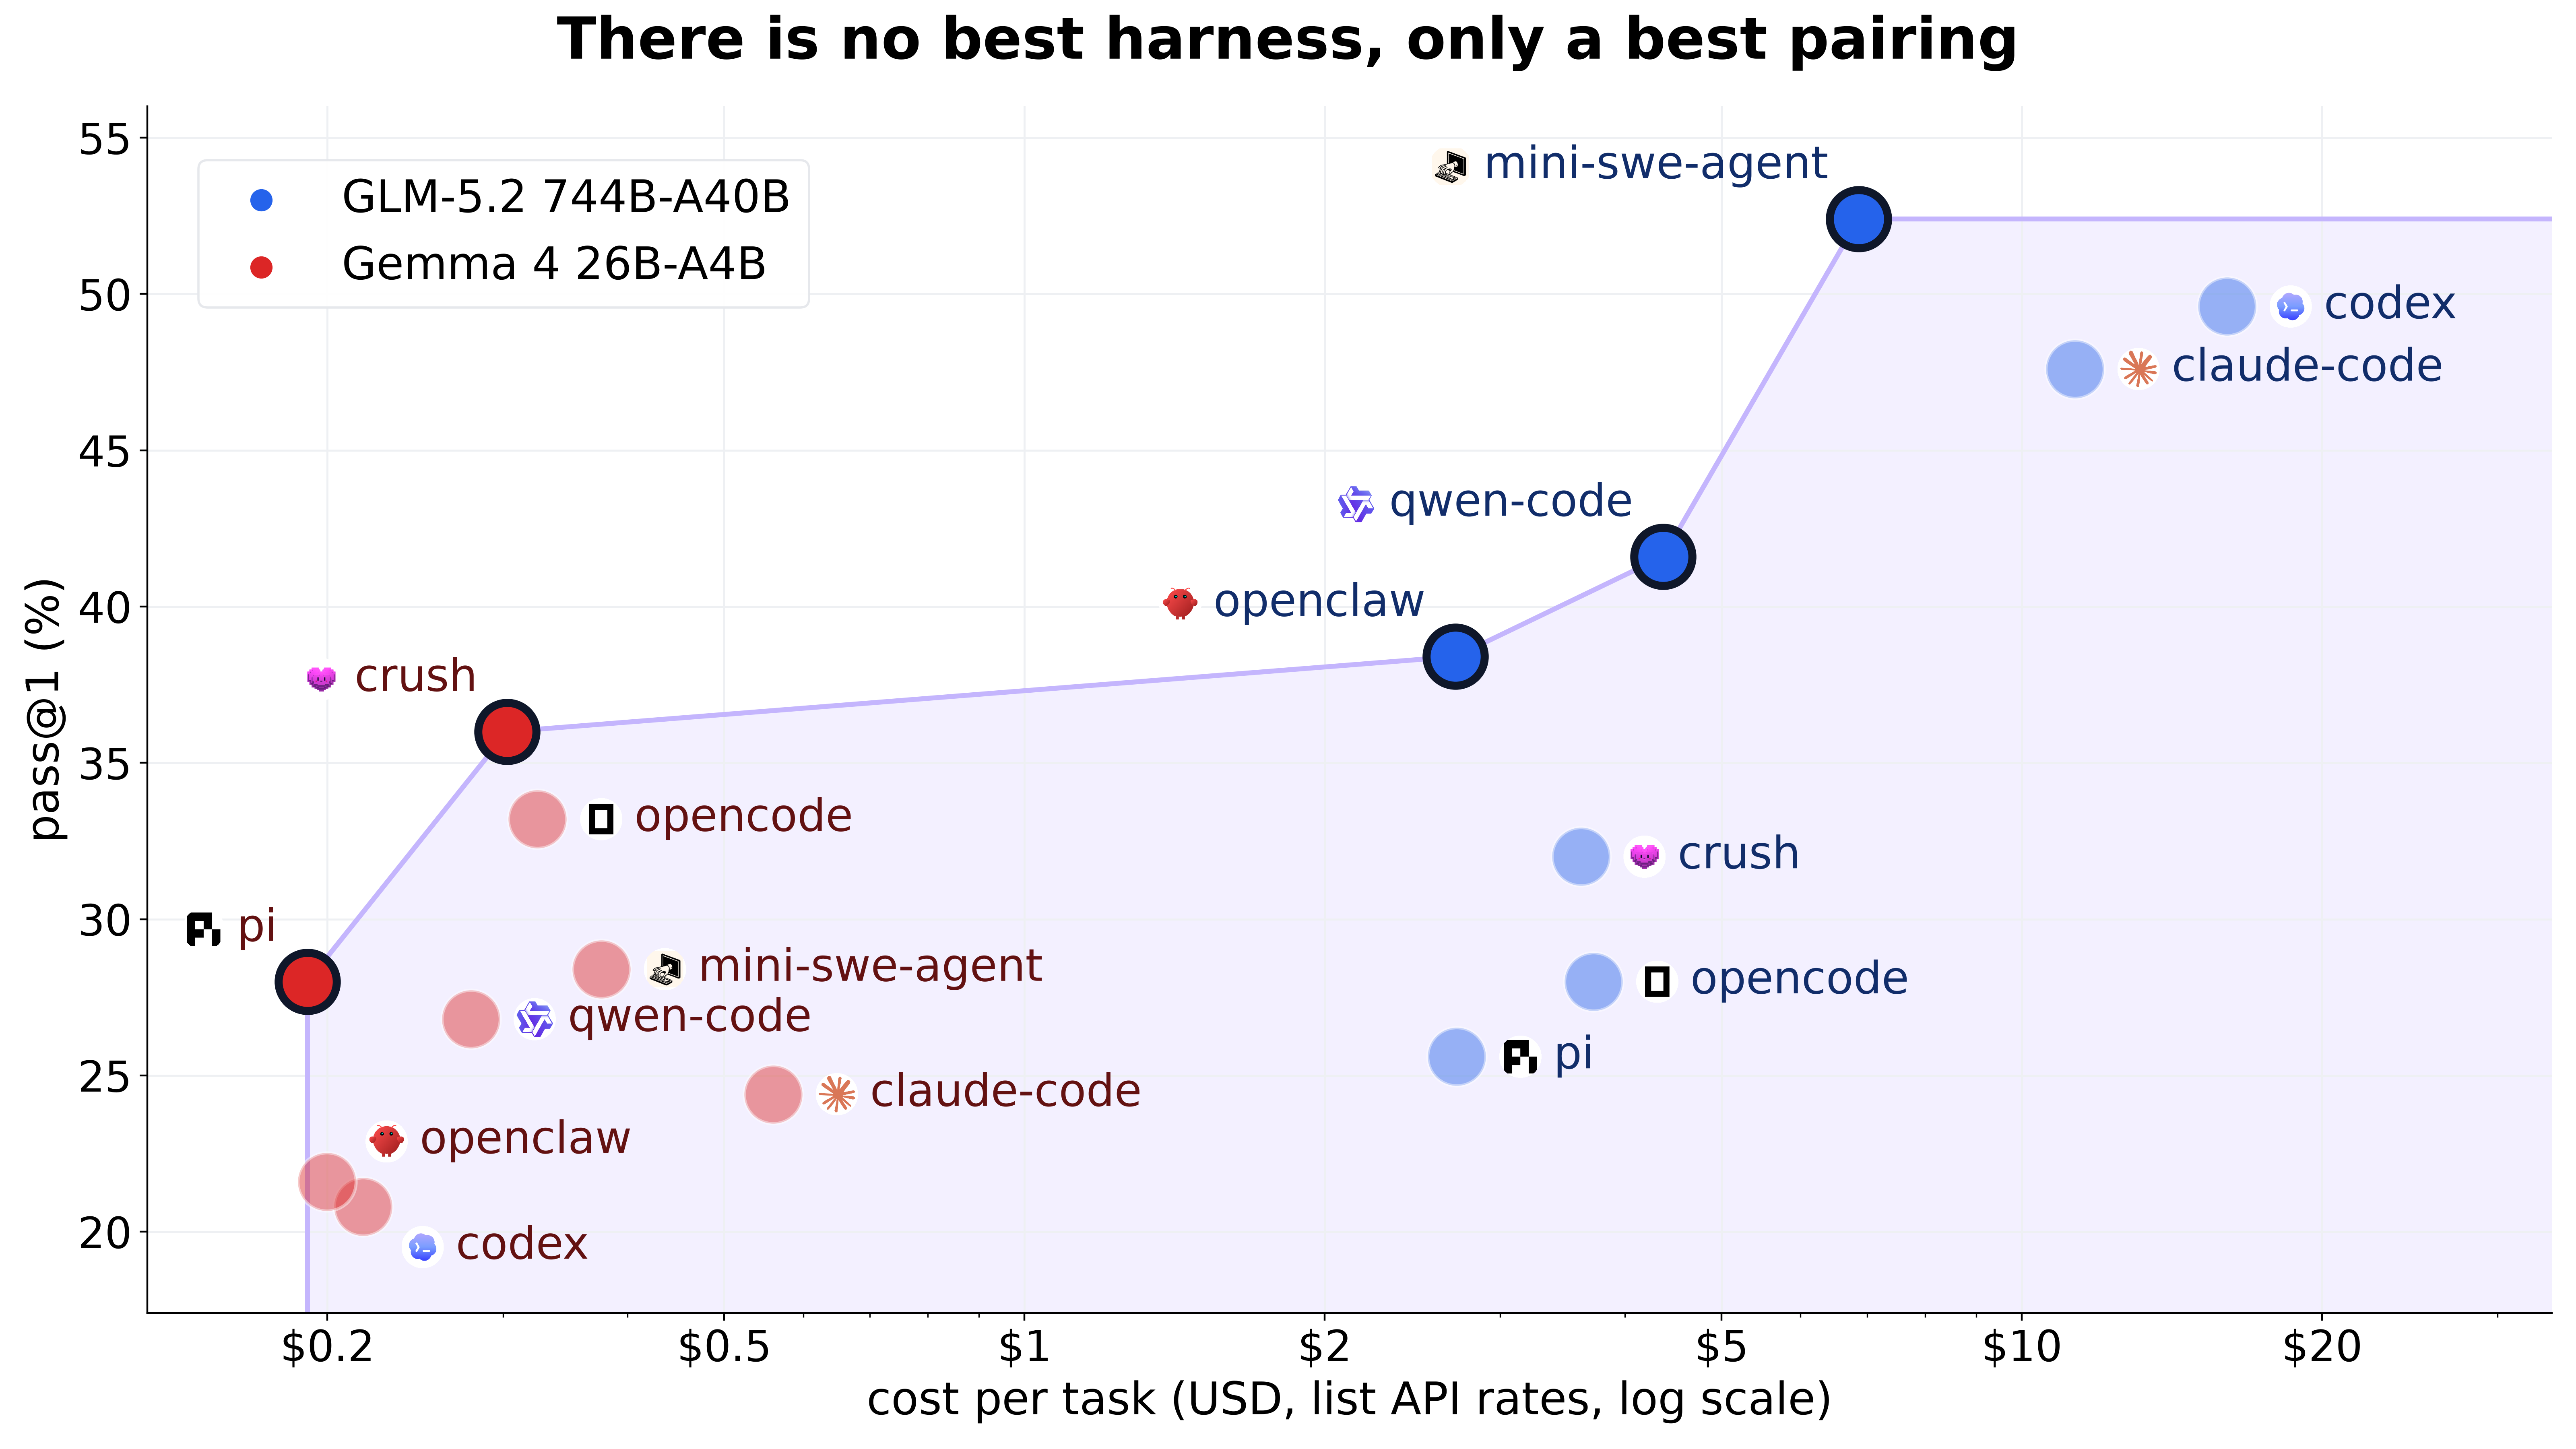
看这张原图,先认清两块面板对应不同模型,再看每个点的准确率与任务成本。它支持“模型与运行框架的搭配很重要”;不能据此给所有模型排出同一套框架优劣次序。
二、强化学习怎么教 AI 做一串事情
普通监督学习(SFT)大致是给模型看“问题—成功解法”的示范,让它学习生成类似的内容。强化学习(RL)则让模型实际行动,依据反馈调整以后采取行动的概率。
所谓 agentic RL,就是强化学习的对象不再只是一段最后答案,而是带工具的一连串行动。一次完整尝试称为 rollout:读任务,发出工具调用,观察结果,再行动,直到提交或终止。
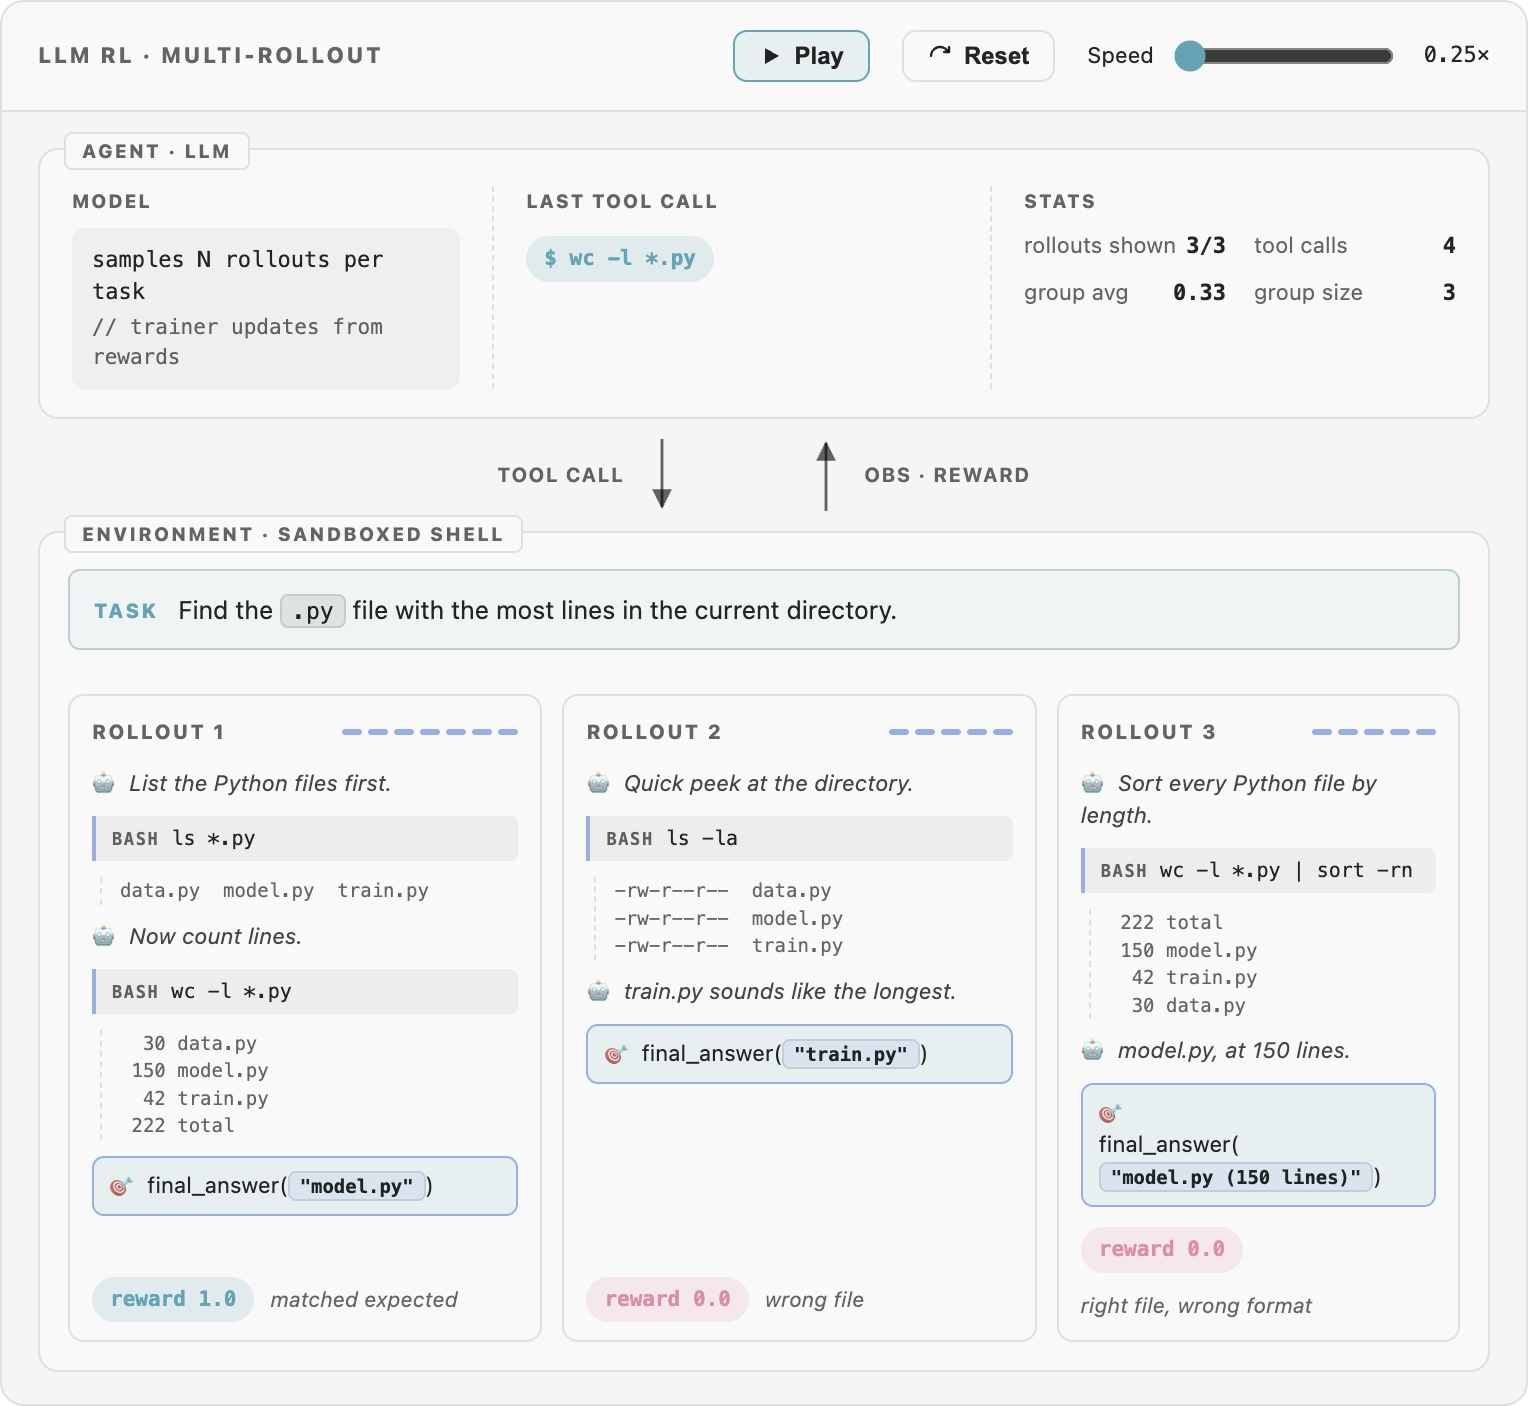
视频里点击 Play,模型生成行动,工具运行,执行结果返回,最终出现奖励和更新。Reset 回到起点;速度滑块改变演示速度。它是机制示意,界面中跑得快不代表真实训练吞吐。
假设要从一张表计算平均值。AI 可能先检查列名,再读取数据,再处理缺失值,再计算。最终平均值正确,训练器会提高这条尝试中有关生成行为的相对概率;若错误,反馈可以帮助它降低一些行为的相对概率。
但“最后成功”并不等于每一步都值得鼓励。如果奖励只看是否提交,它可能学会不检查就提交;如果过分奖励少调用工具,它可能省略必要验证。奖励定义就是你真的在教什么,而不只是一个统计指标。
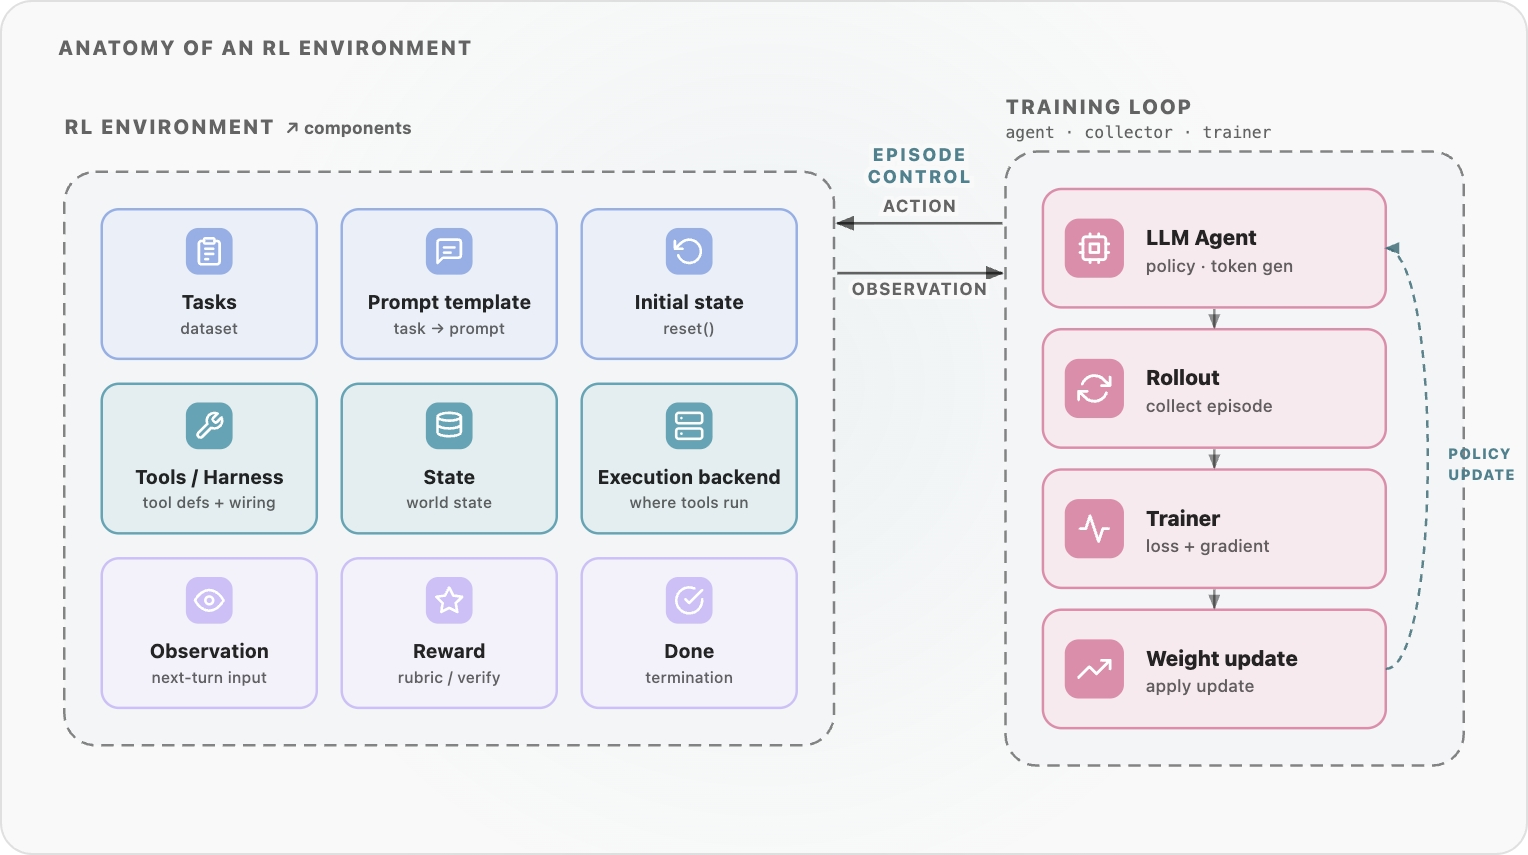
这张环境示意把行动、观察、奖励与训练连接起来。重点看反馈从任务执行后返回;它不是模型自报的“我认为我做对了”。
三、谁掌握行动循环,决定训练器能看见什么
在一种训练方式里,训练器自己调用模型、执行工具、保存每个 token,再发起下一轮。作者把这种情形称为 white-box:训练器掌握循环,数据比较容易记录。
另一种方式让已有的软件照常运行。Claude Code、Codex、OpenCode 等程序自己决定何时向模型发请求、如何组织上下文、什么时候调用工具。训练器在外围接收完整尝试。这就是本文所说的 black-box:外部软件掌握循环。
这里的“黑箱”不是说无法观察,也不是所有论文里 white-box/black-box 的统一定义。不同报告可能用这些词描述其他层次,不能只看标签就当成同一方法。
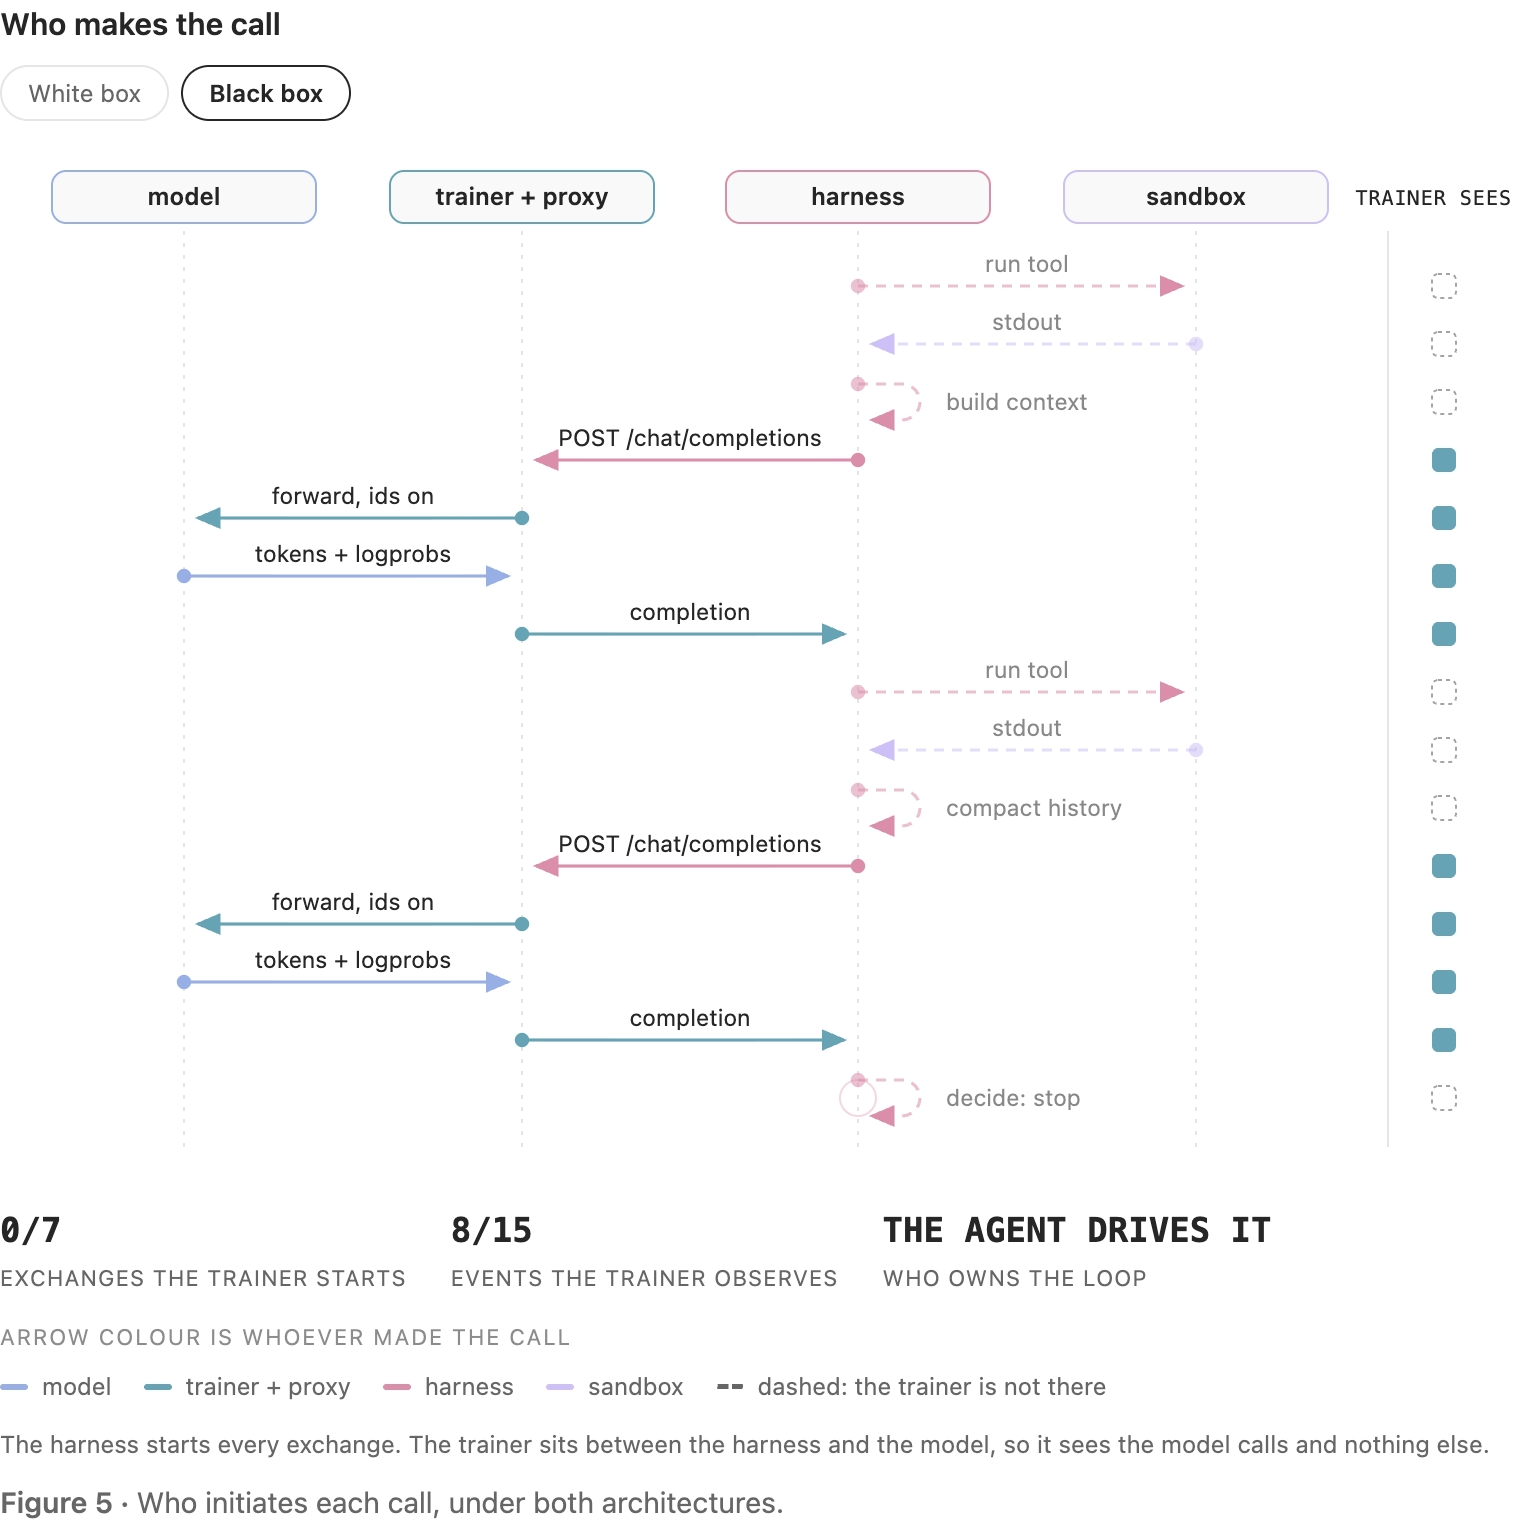
切换两个按钮,看谁负责发起下一步。白箱模式中训练器在循环内;黑箱模式中 harness 在循环内,训练器通过模型接口和任务结果取得记录。
困难在于,训练器需要的不只是“题目、答案、分数”。它还要知道:当时真正输入模型的 token 是哪些;模型真正采样出哪些 token;每个生成 token 在当时策略下的概率是多少;哪些位置是模型的行动,哪些是外部上下文。
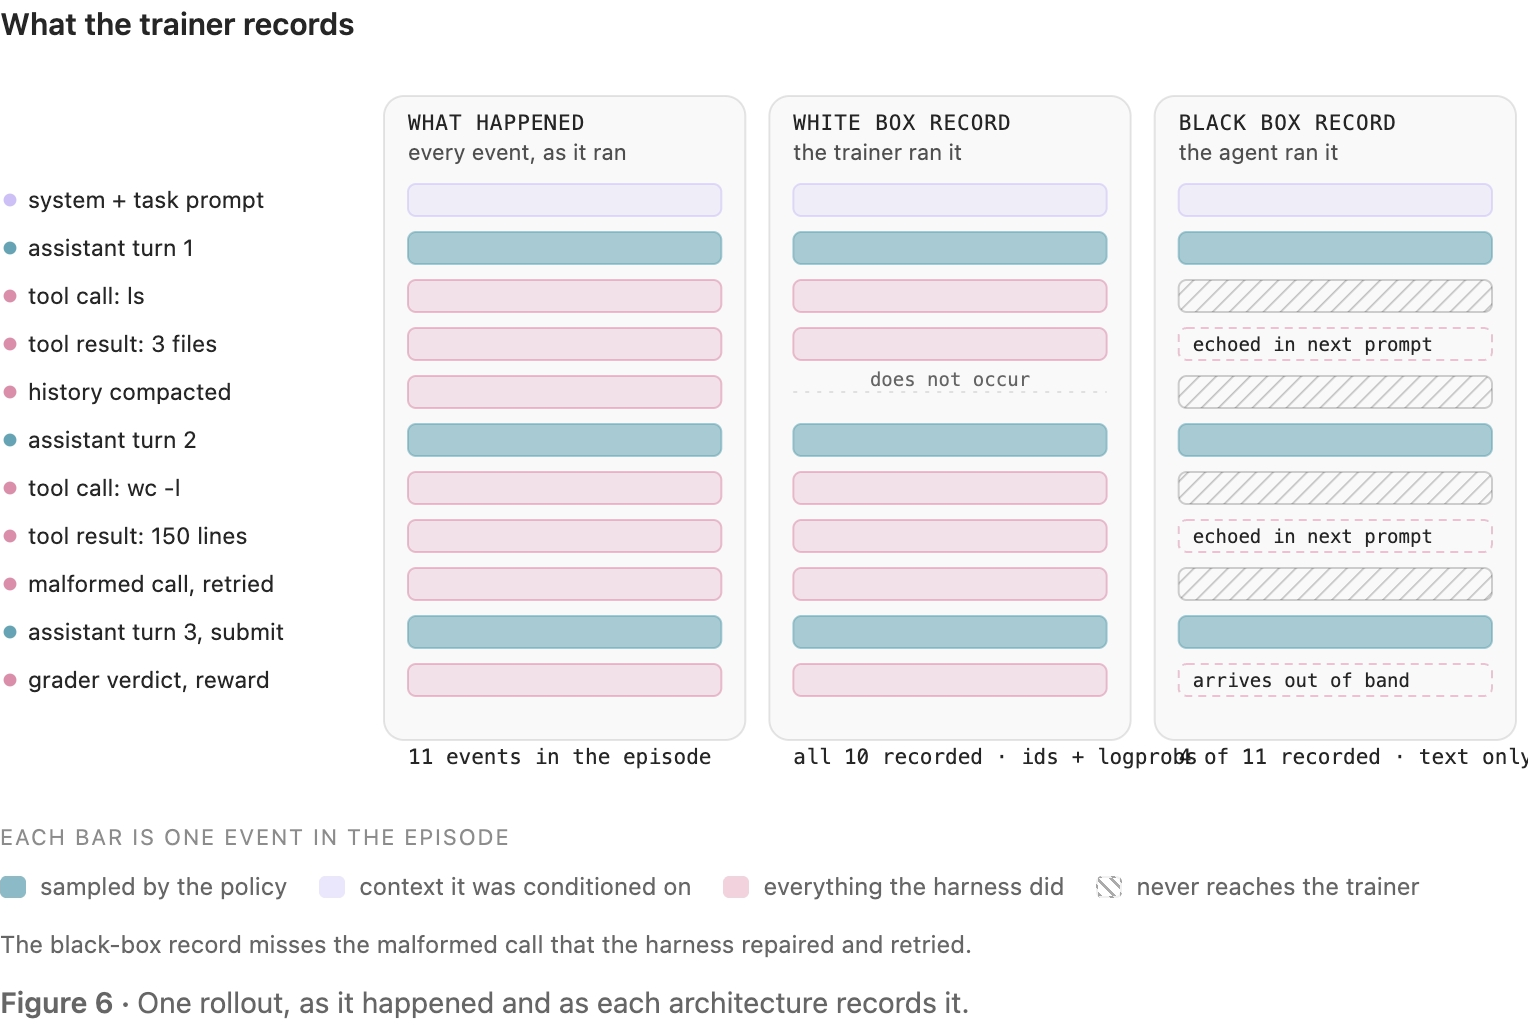
训练记录的图展示了文字、token 与概率之间的对应关系。正文读者不用记住每个编号,但要记住“保存可读文字”和“保存训练需要的精确记录”是两回事。
为什么重新把文字编码一遍,可能出问题
Token 是模型处理文本的基本片段,不一定是一个字或一个完整单词。同一段可读文字,经过不同的拼接方式、模板或编码边界,得到的 token 序列可能不同。
Harness 还可能修复模型生成的 JSON,把错误输出整理成可执行结构,或者在下一轮删除、重写、压缩之前的对话。训练器若对这些处理后的文字重新编码,可能得到“模型并没有实际生成过的序列”。
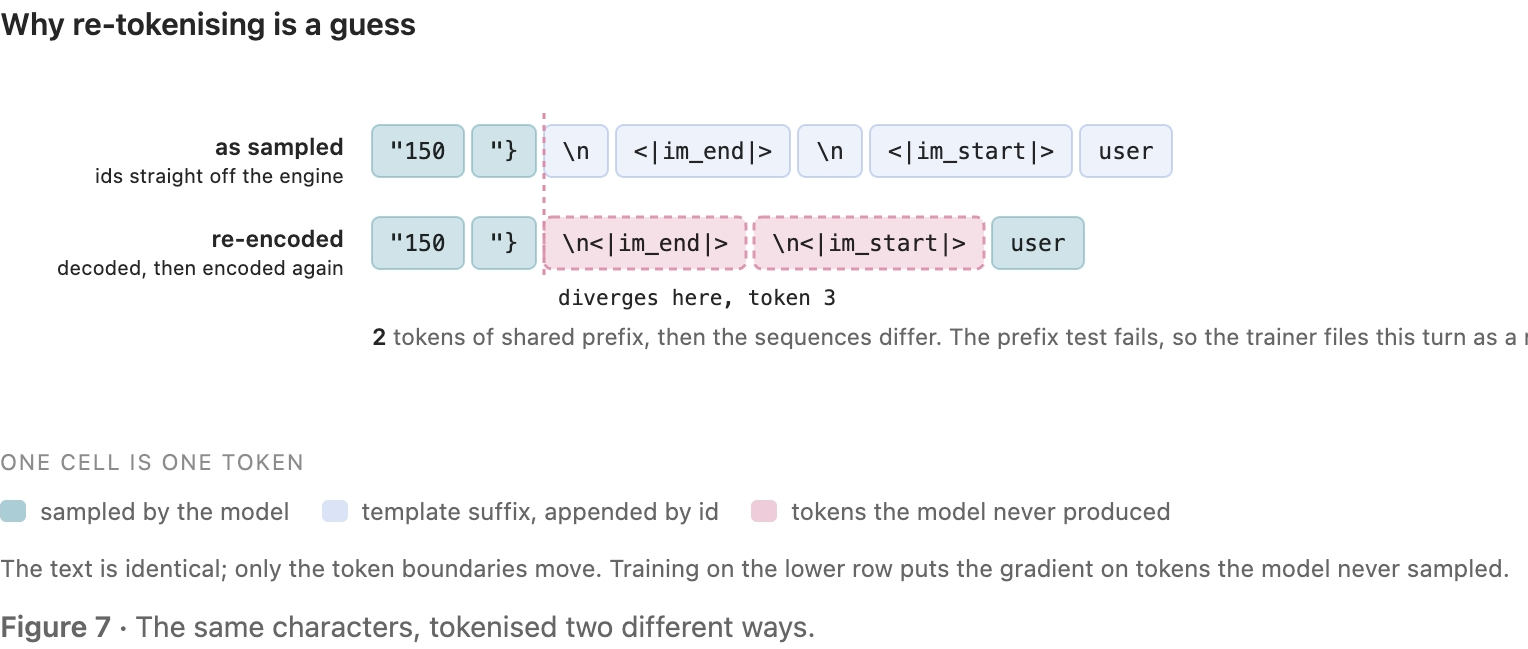
这张漂移图的重点是 token 边界和序列是否保持一致。文字看起来相同,并不能自动保证训练记录一致。
在异步训练中,这更加重要:生成端可能还在用较旧的模型权重,训练端已经更新。训练器比较新策略与当时行为策略的概率,需要保存当时采样的行为概率,不能拿后来重新算出的数冒充。
不过,作者也讨论了通过文本代理取得较强结果的 OpenForgeRL。本文的精确 token 合同,是这套实现的训练要求;不能把它夸大成“任何文字轨迹方法都无效”的普遍结论。
四、为什么只在一个框架中训练,可能学偏
模型会学到完成任务的知识,也可能学到某个框架特有的习惯:某种工具名、某种输出格式、某段历史的组织方式、某个停止信号。
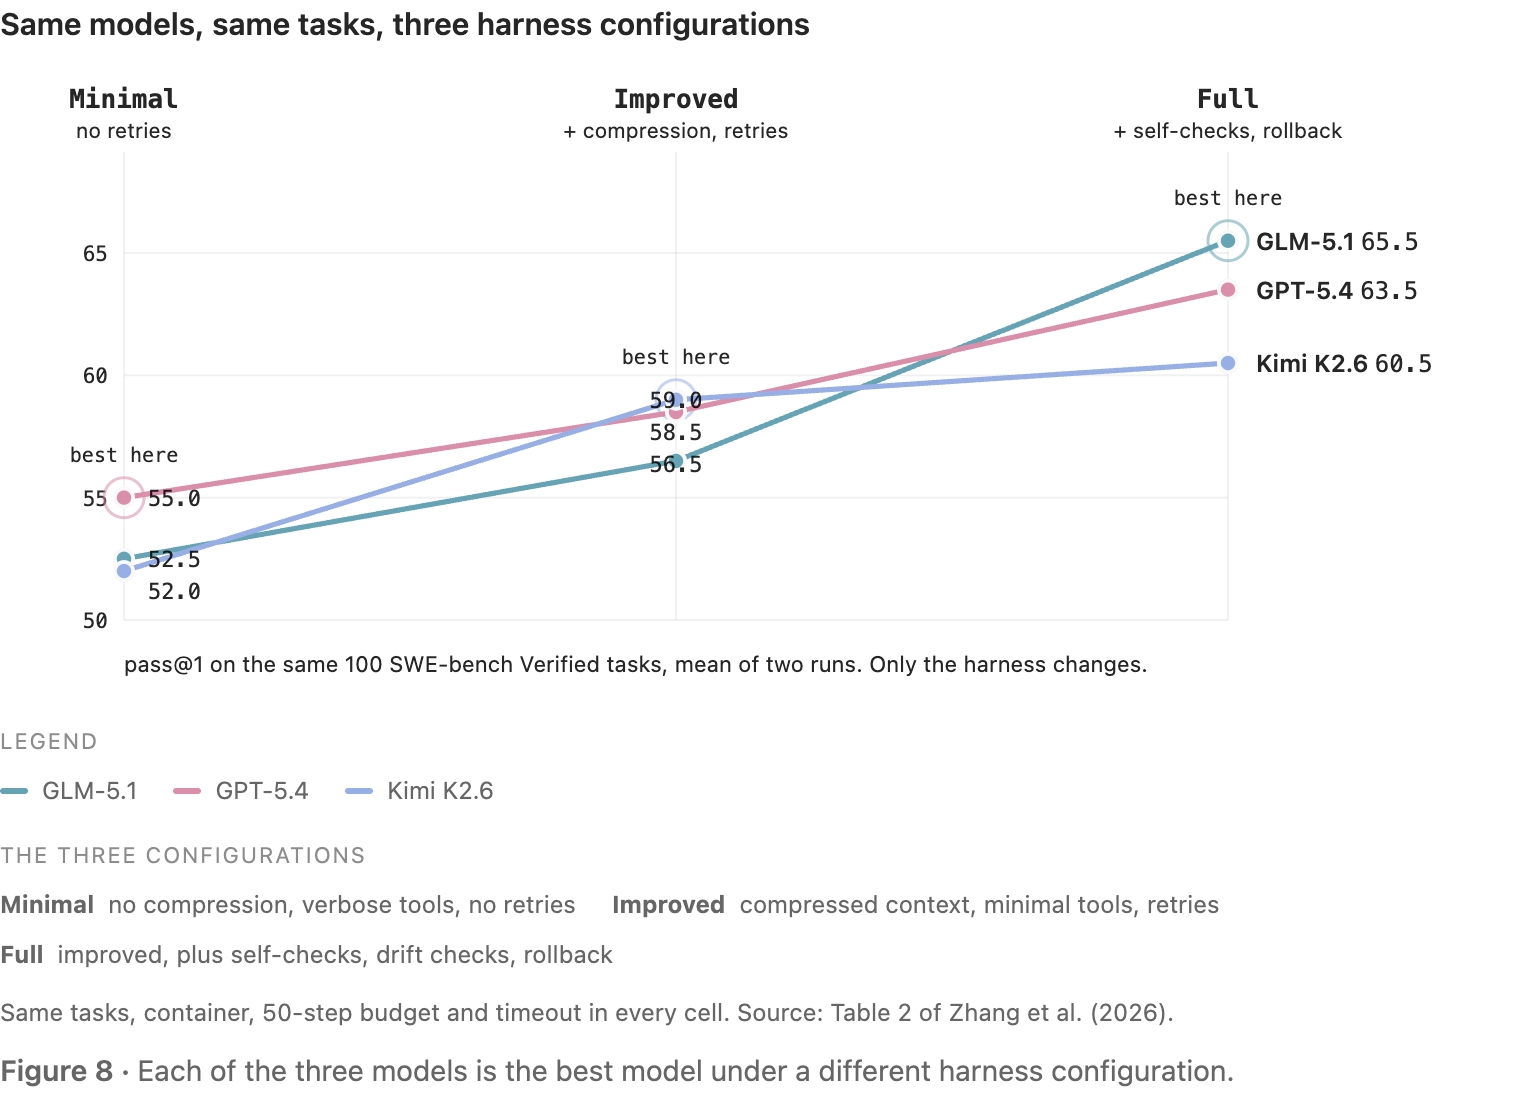
这张图比较 GLM-5.1、GPT-5.4、Kimi K2.6 在相同的 100 道 SWE-bench Verified 任务上,用三种递进配置作答:Minimal 没有上下文压缩和重试,Improved 加入压缩与重试,Full 再加入自检、偏离检查与回滚。三个配置中,胜出的模型分别不同。
原图保留 50–67 的局部纵轴,读线条时要看刻度,不要把视觉上的距离当成从零开始的巨大差距。作者引用的例子中,换框架让 GLM-5.1 变化 13 个百分点,而在同一配置中换模型的差别约 2.5–5 点。这是特定受控测试,不是所有AI的普遍定律。
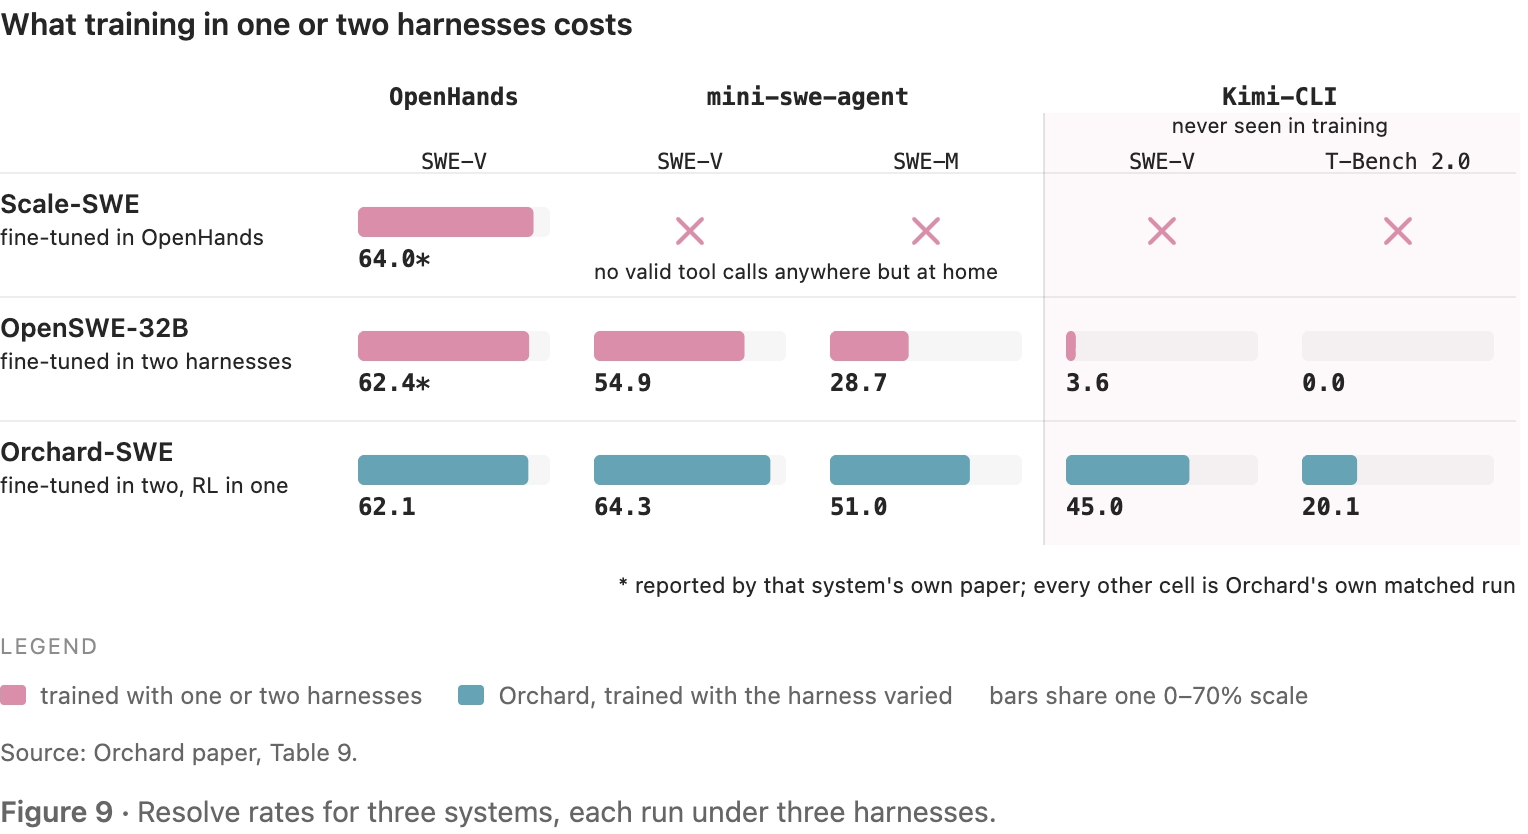
这张图来自 Orchard 报告中的跨框架测试,不只是概念插画。例如原文转述,OpenSWE-32B 从其原生 OpenHands 转到 Mini-SWE-Agent,解决率降约 7.5 点;换到 Kimi-CLI 时,在该 SWE-bench Verified 配置下降约 58.8 点至 3.6%。
落差要分两种:仍能正常行动,但做对的题更少;或者输出格式已经无法形成有效工具调用。这份报告的任务和模型不等于下文 LFM 实验,不能把数字拼进同一张排行榜。
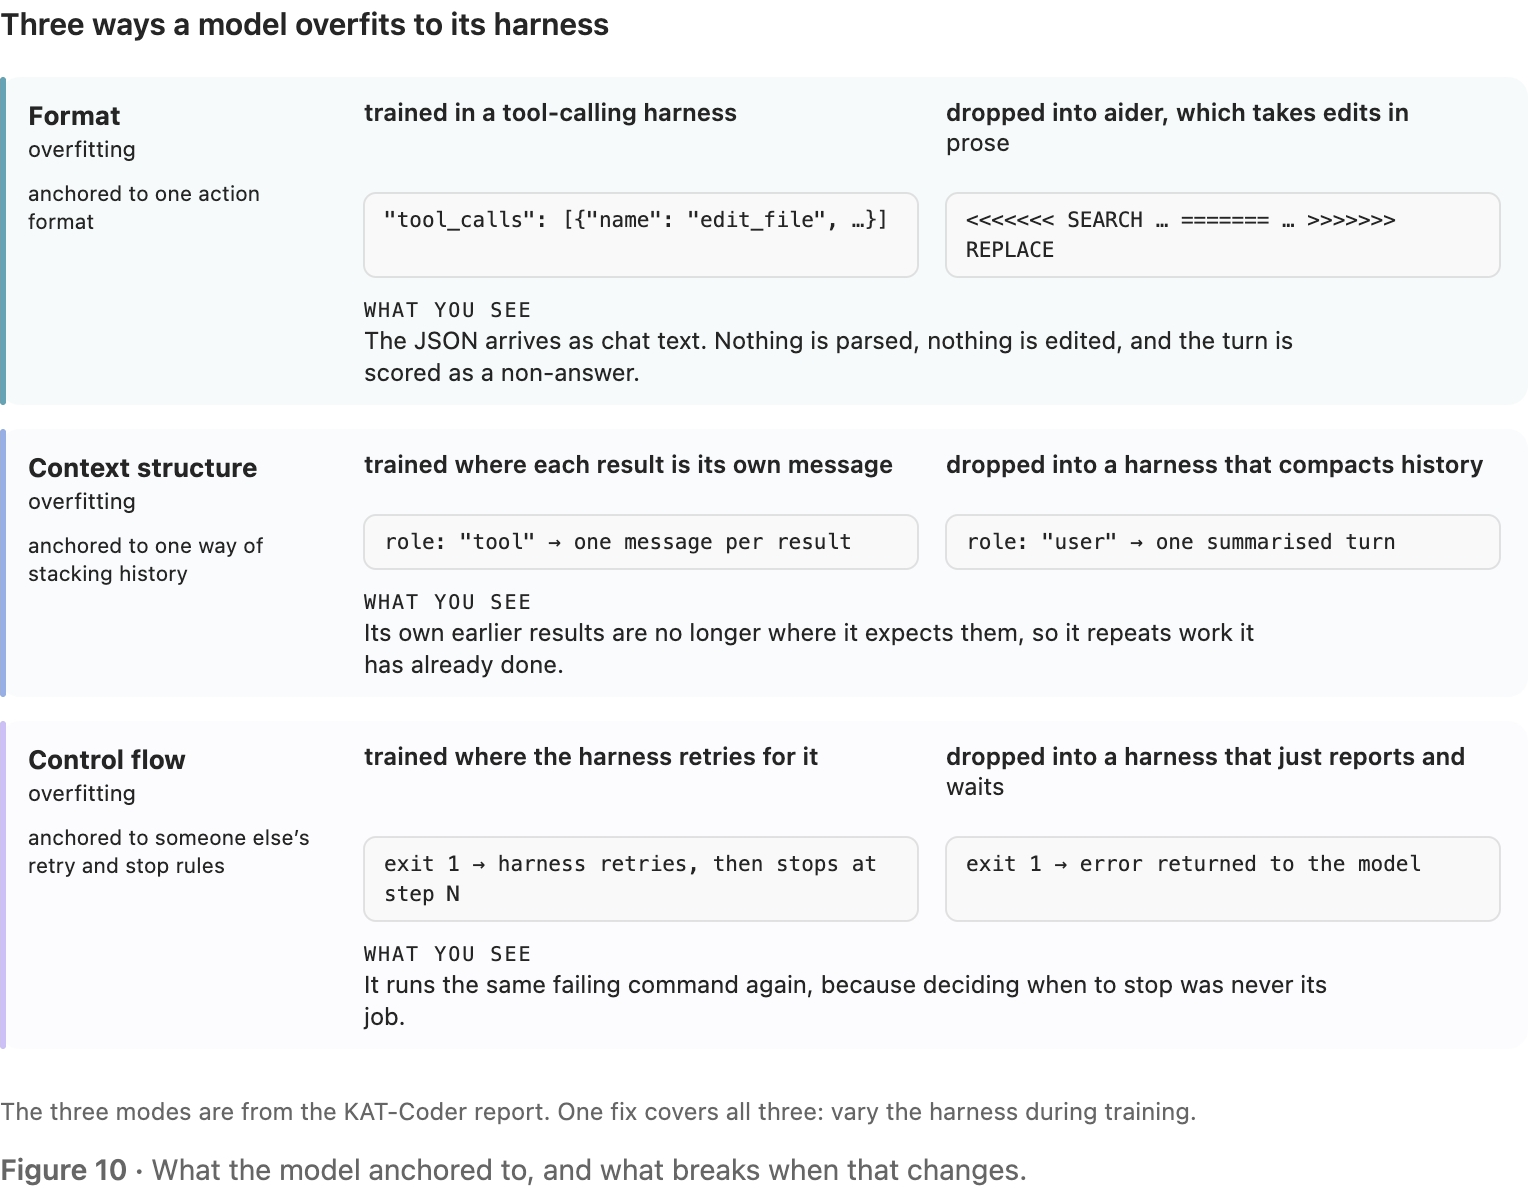
这张图把可能的过拟合分为几类。重点分别看工具名称、输出协议与工作过程:它们是迁移可能失败的路径,不是已经逐一得到消融验证的原因。
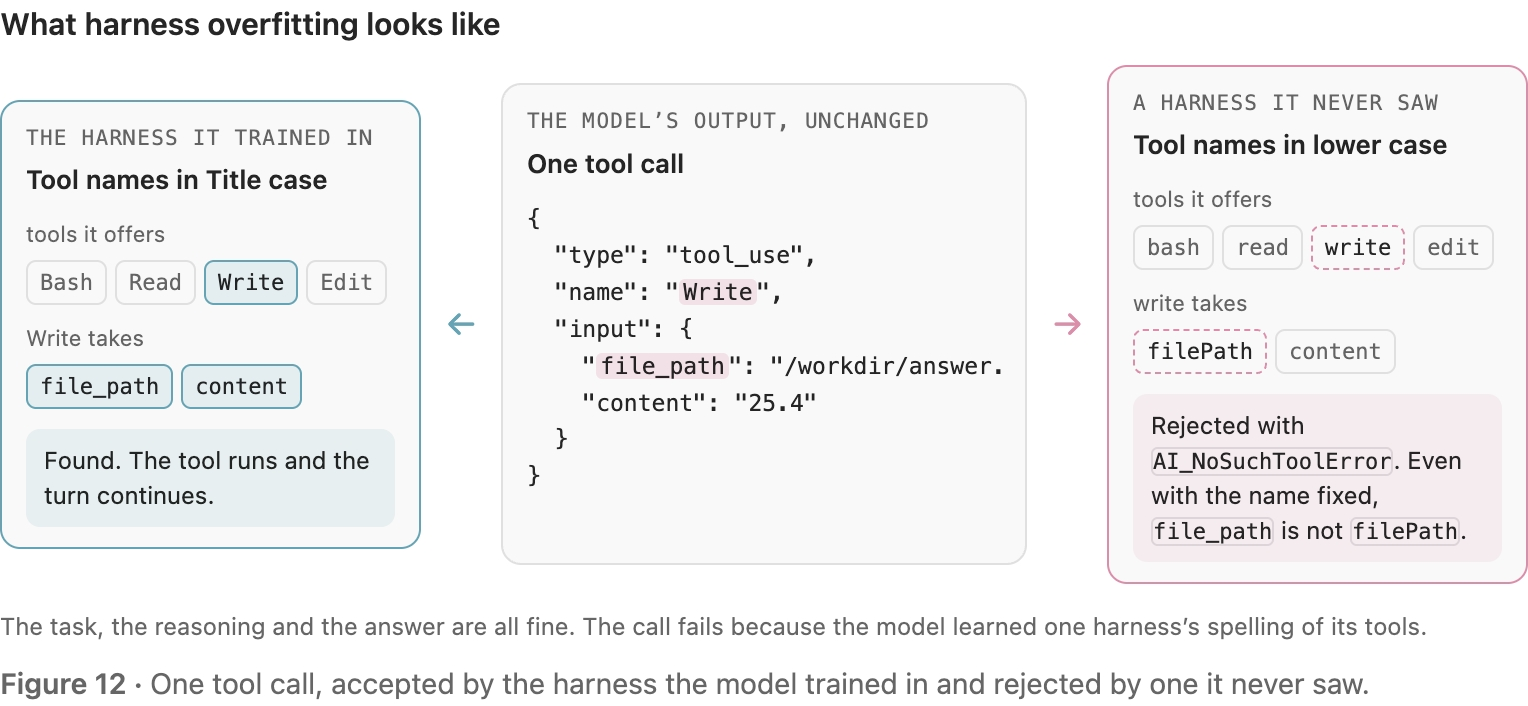
格式不匹配图提醒读者:模型“想做的事情”可以是合理的,但如果返回结构不合接口合同,工具仍无法执行。这属于系统协作问题。
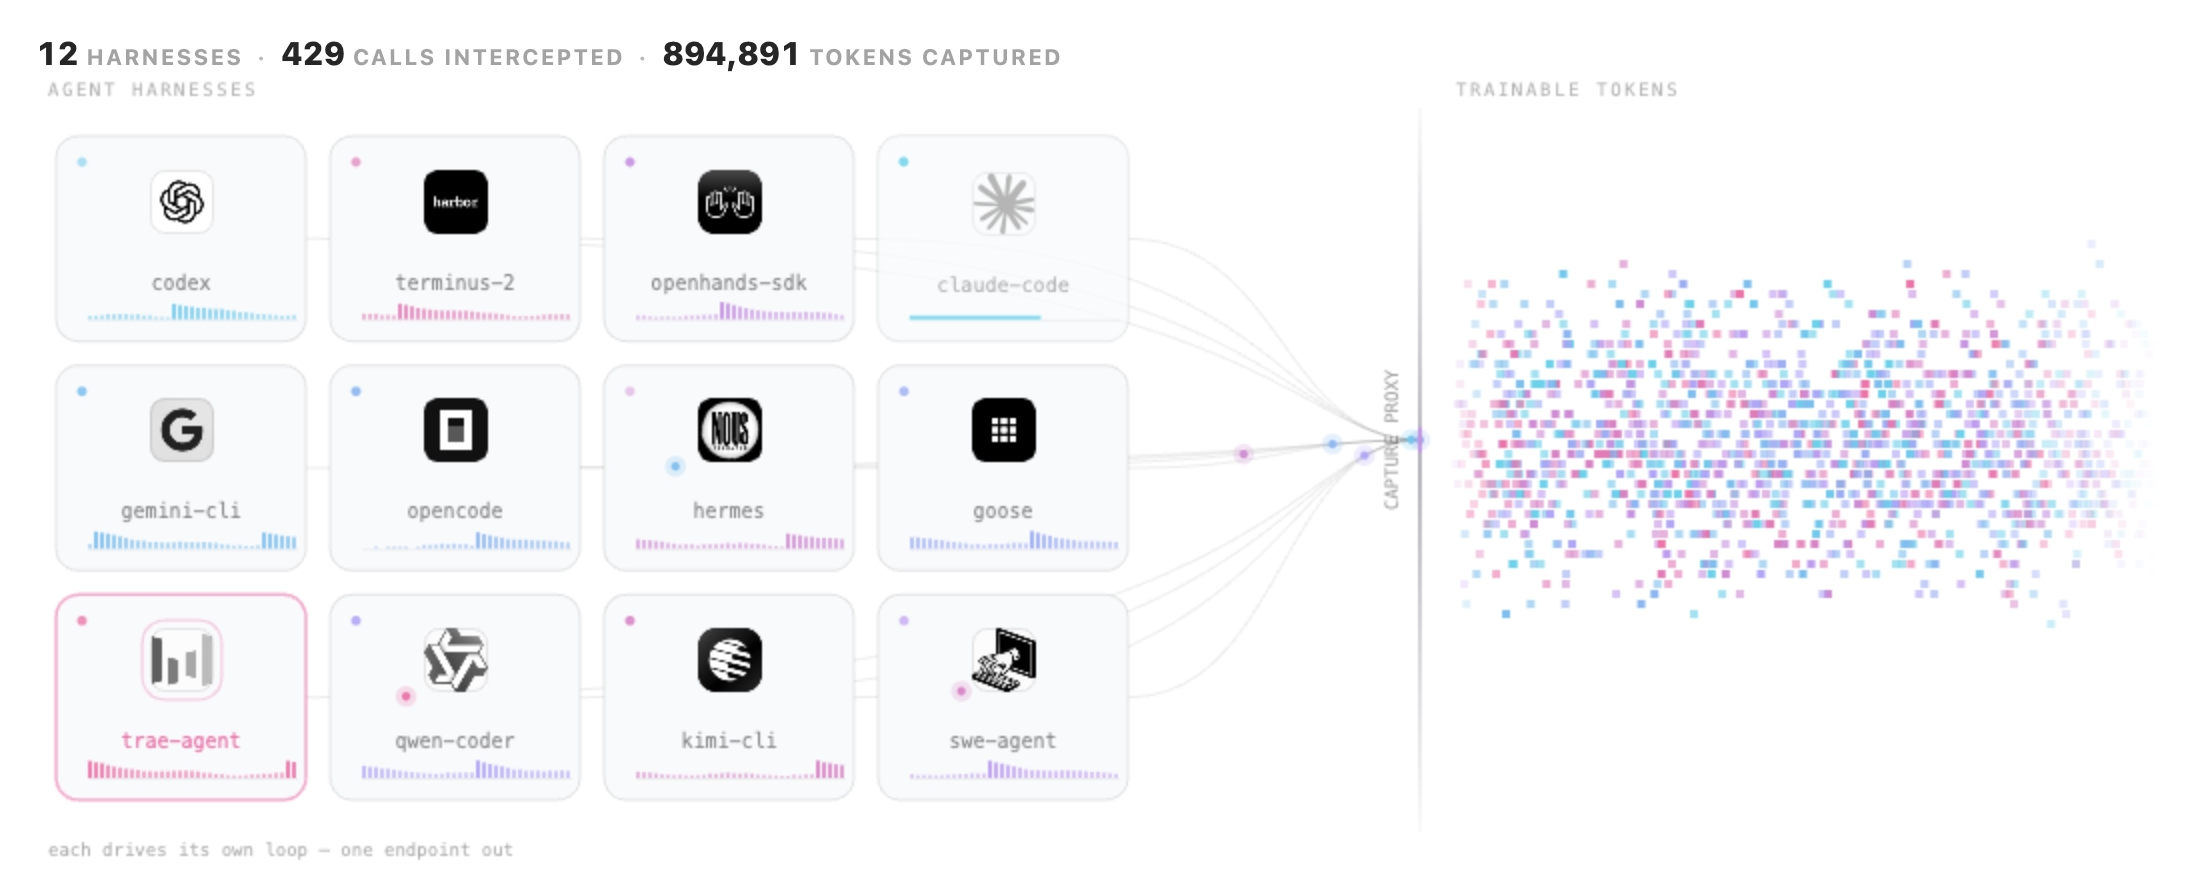
原网页还列出 12 种运行框架与它们使用的模型 API。这个生态表不是训练对比的十二个实验组。
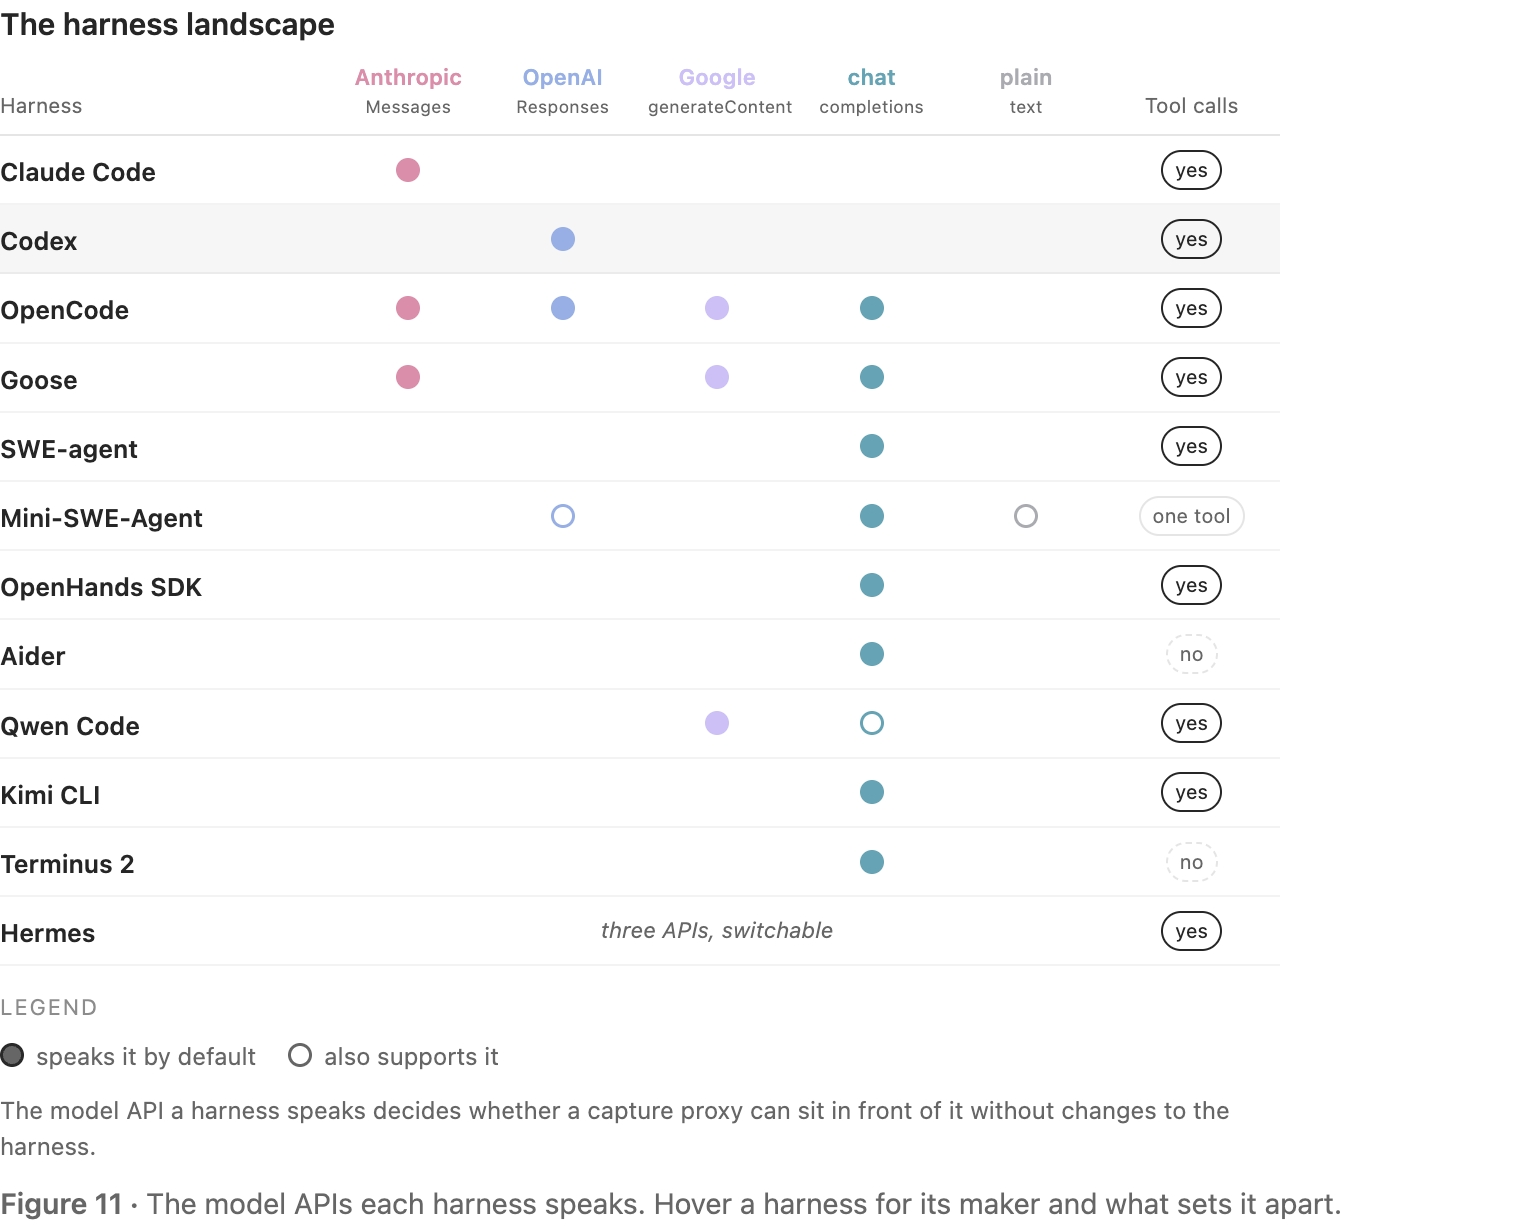
阅读时按列看接口协议,再按行看程序。下文核心训练只使用四种 harness;另有十种通过捕获合同检查,三个数量分别回答不同问题。
相关论文的原始摘录:保留证据,也保留分寸
原网页提供八张报告摘录。下列图片是网站作者从官方报告制作的原始摘录图,本文保留取得的文件字节,不再裁切或改写。报告结论属于各自的模型、任务和实验配置,不能被拼成同一项大规模验证。
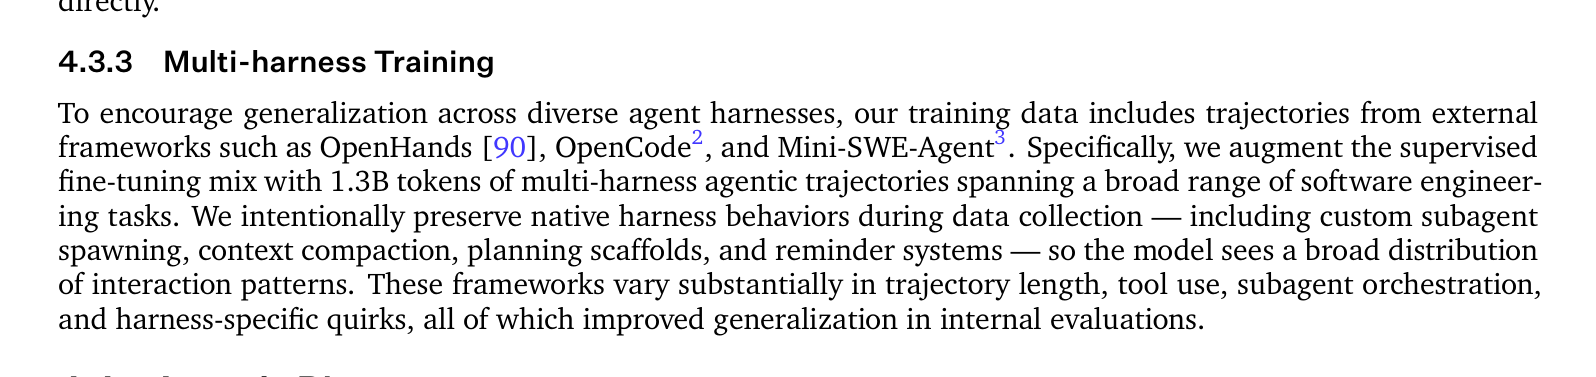
来源图 ID:paper-laguna。Poolside LAGUNA 原报告,第20页,多框架训练段落。关注它如何将多种运行方式纳入训练;这是该报告自己的配置。
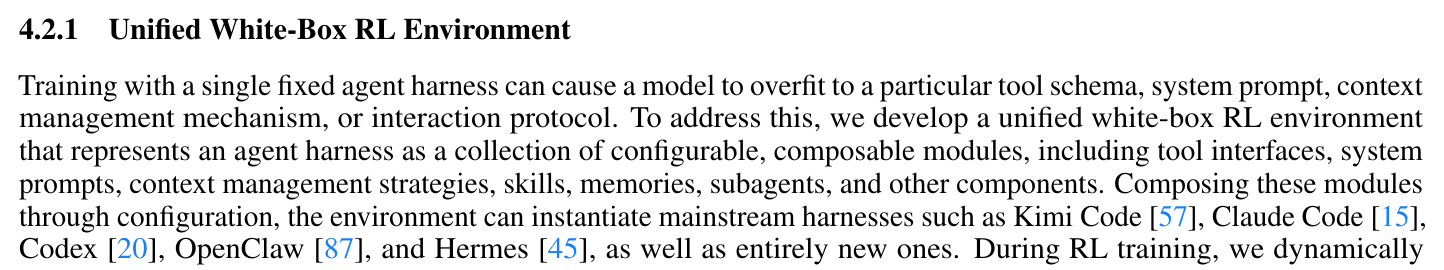
来源图 ID:paper-kimi。Moonshot Kimi K3 原报告,第14页,统一白箱RL环境。关注循环控制与轨迹组织;其白箱术语须结合原报告定义。
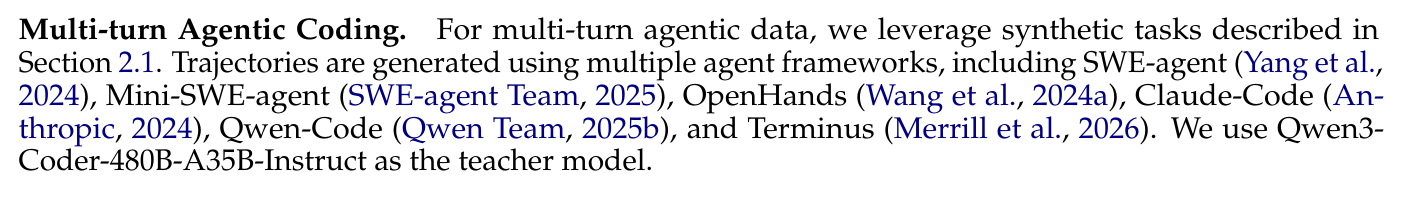
来源图 ID:paper-qwen。Qwen3-Coder-Next 原报告,第5页,多轮智能体代码数据。它说明训练数据如何覆盖工具过程,不等于本实验的结果。
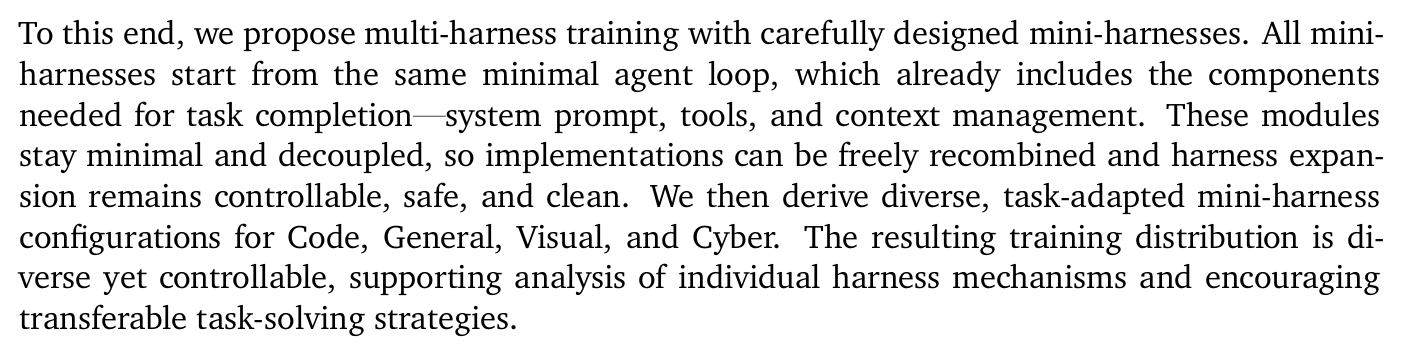
来源图 ID:paper-mimo。Xiaomi MiMo-V2.6 原报告,第14页,多框架训练。关注跨框架的训练讨论,不将该模型成绩移植给LFM。
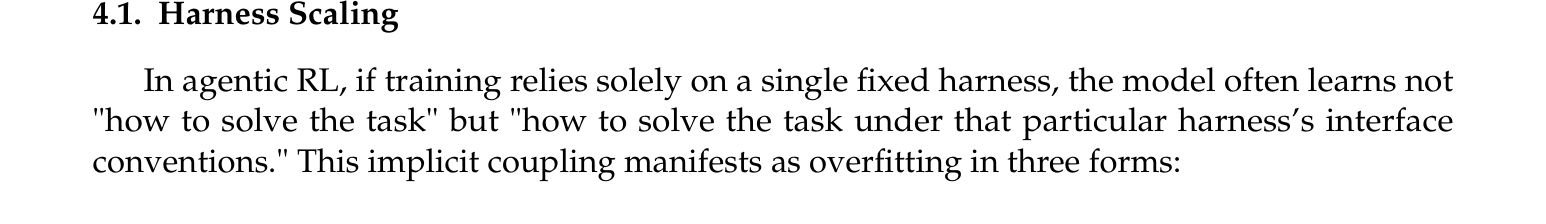
来源图 ID:paper-katcoder。KwaiKAT KAT-Coder-V2.5 原报告,第9页,Harness Scaling。关注框架扩展;其中白箱/黑箱分类不必与本文同义。
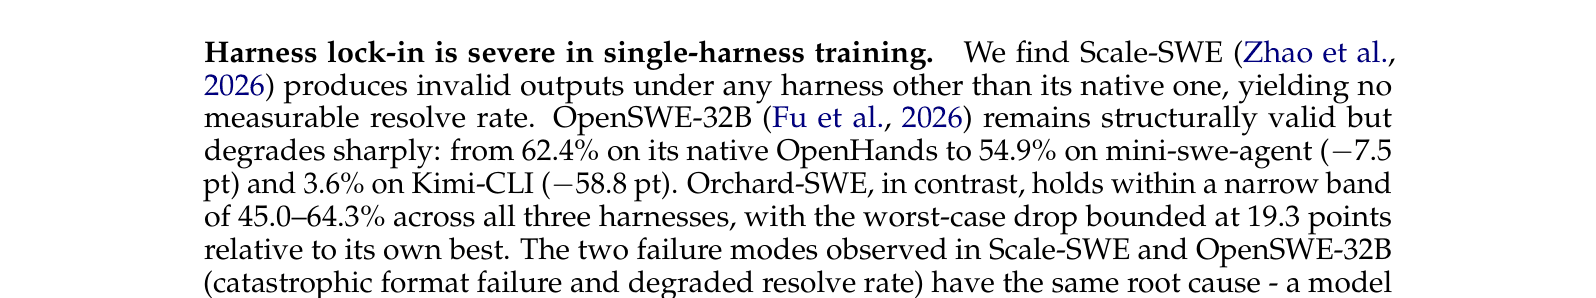
来源图 ID:paper-orchard。Orchard 原报告,第20页,框架锁定讨论。支持需要关注单框架训练迁移问题,而非普遍失败断言。
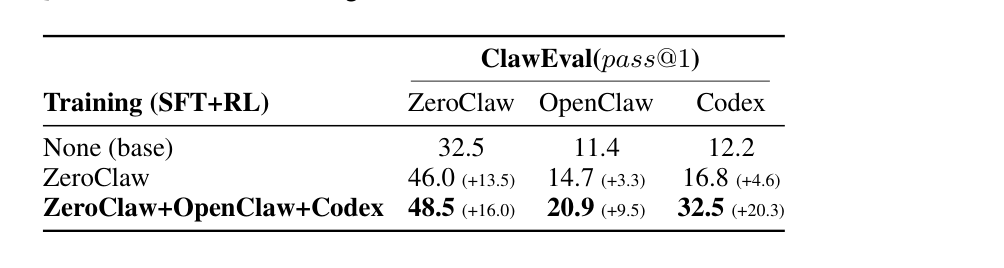
来源图 ID:paper-openforge。OpenForgeRL 原报告,第9页,表5。看一框架与三框架的消融;也提醒文本代理路线不能被简单宣告无效。
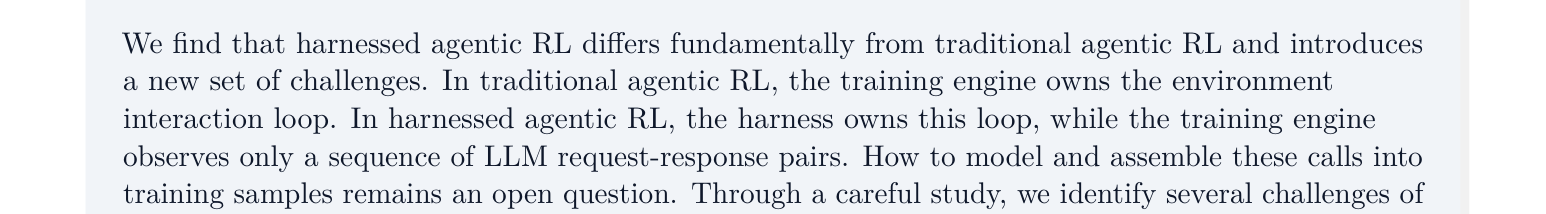
来源图 ID:paper-agentlt。Microsoft Agent Lightning 原报告,第1页摘要,循环归属。关注现有智能体软件与训练器的连接,不认为所有实现细节完全一致。
这些材料共同推动了一个问题:训练能否覆盖真实部署时的运行方式?它们并没有提供一套任务、数据量、计算预算都严格相同的统一比较。
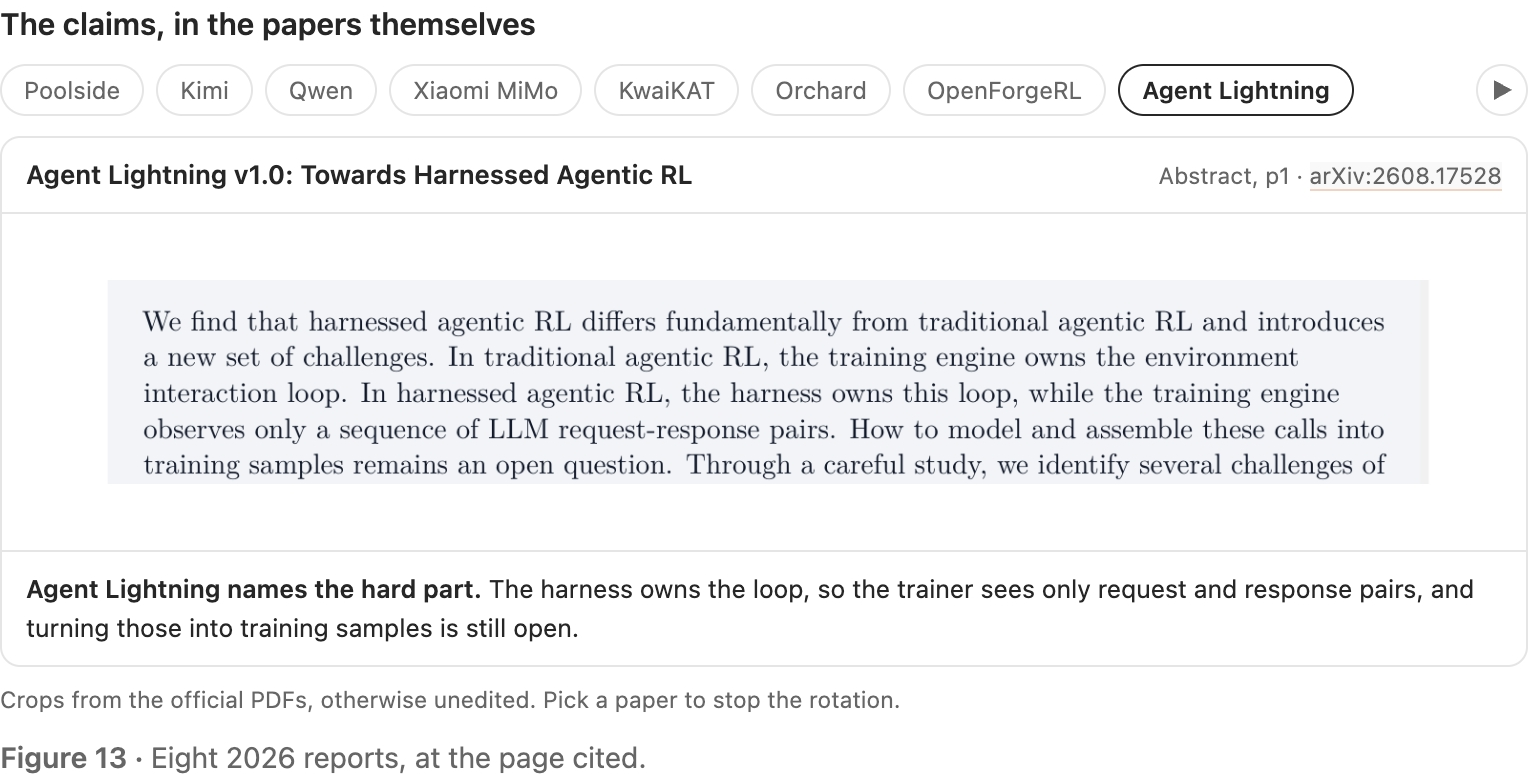
原网页的证据页签把八张摘录放在同一个交互模块里。视频展示逐项切换,便于看清不同报告来源。上方原始摘录则供逐张放大阅读。
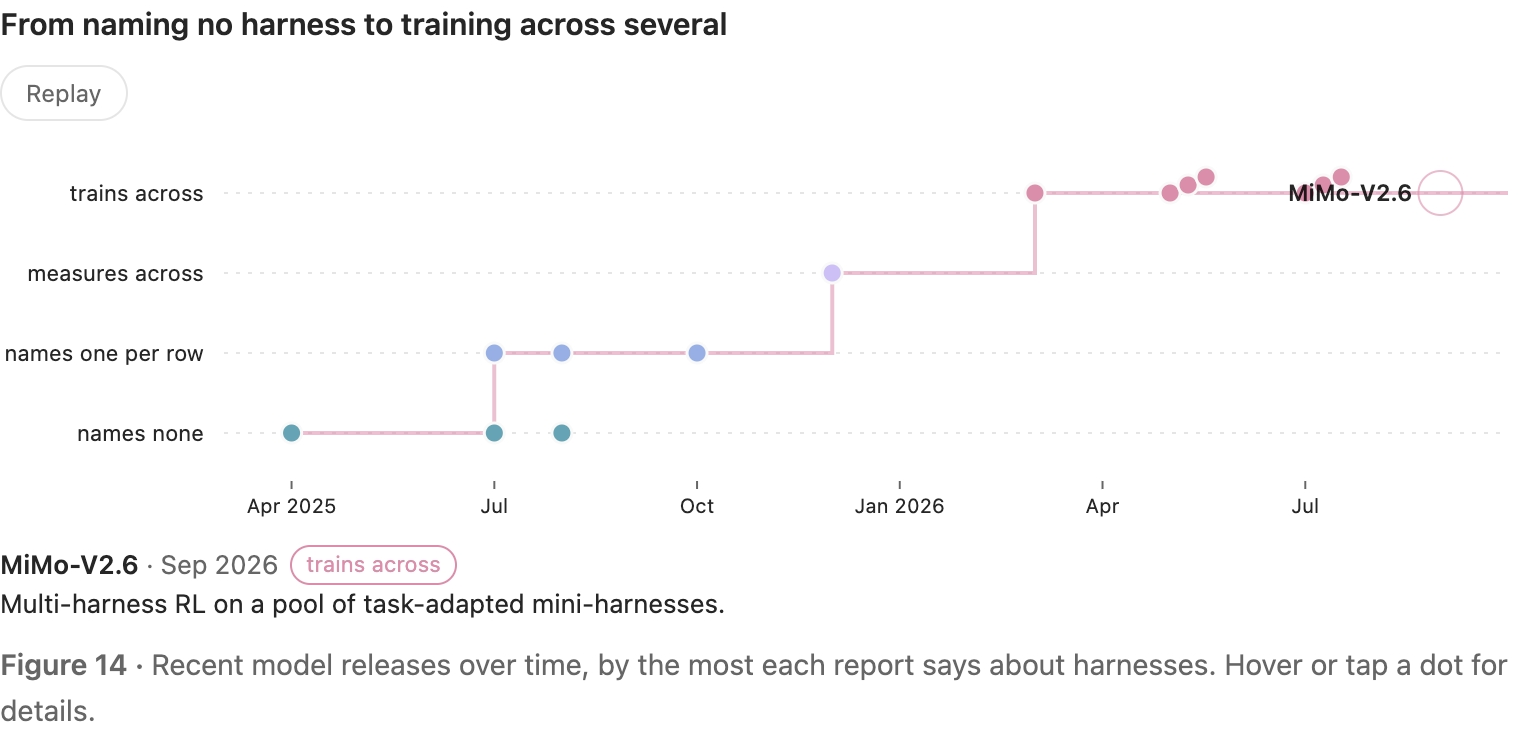
这条时间线按作者的分类,展示报告从“不说明框架”,到“每行标明框架”,再到跨框架测量与训练的披露变化。它衡量的是这些报告如何描述 harness,不能解释为整个行业的采用比例。
五、OpenEnv、Harbor、TRL:把做题、记账、学习分开
这套实现有三个主要部分。Harbor 提供任务和沙盒,运行智能体并让自动评分器检查结果;OpenEnv 提供连接接口和捕获代理,把一次尝试的精确记录传给训练器;TRL 更新模型权重。
OpenEnv 本身不替你训练,也不替你决定奖励。它提供类似 reset、step、state 的环境接口和类型化数据。把职责分清,出现故障时才知道检查题目、运行框架、记录链路,还是训练过程。
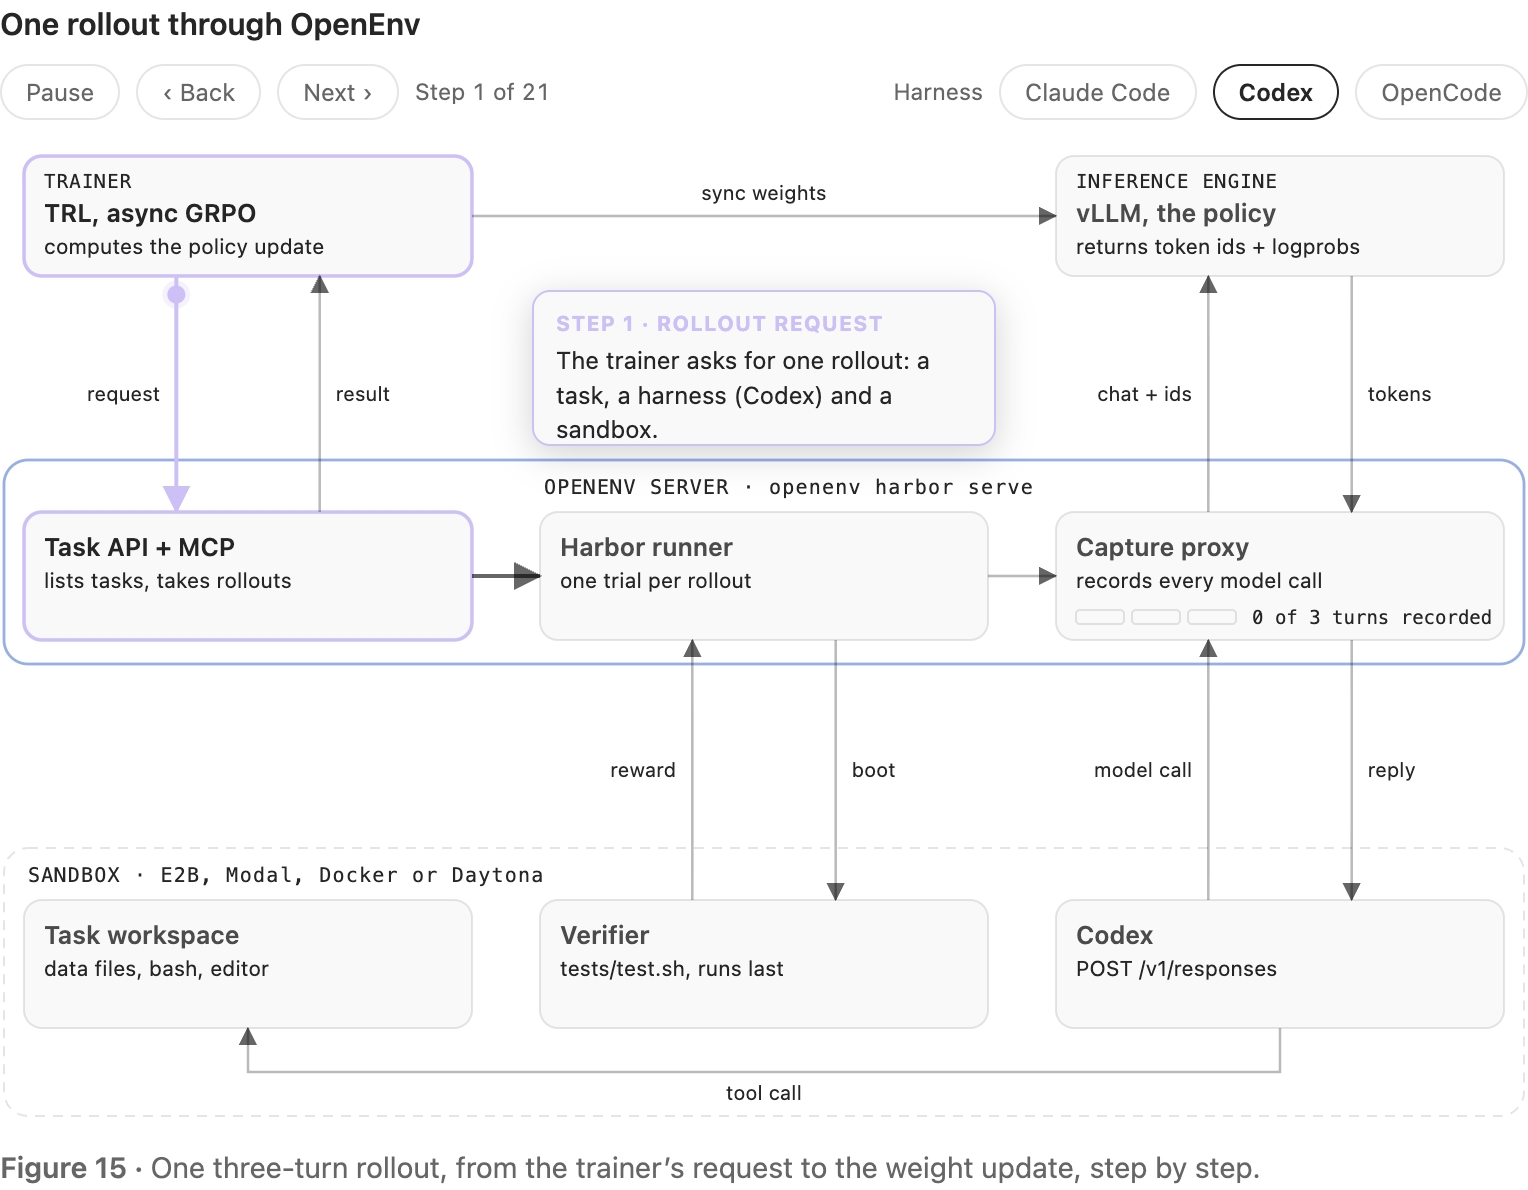
这张图是全篇的总线路。请先沿一次任务读:训练器请求尝试 → 创建工作空间 → harness 发出模型请求 → 捕获代理转给推理引擎 → 回复给 harness → 工具在沙盒执行 → 评分器检查 → 返回轨迹与奖励 → 更新权重 → 新权重送回推理引擎。
它以三轮模型调用为示例,不是规定每道题只能三轮。视频按 21 步走完;切换 harness 改变接线和消息格式,不会把评分器变成模型本身。
捕获代理:像记账员,但必须记到每一个 token
Harness 以为自己正在访问一个模型提供方,实际上请求先经过 capture proxy。代理识别协议、转成统一形式、取得回复、保存 token 和概率,再按 harness 认识的协议返回。
每次 rollout 有自己的 session id,作为这次访问的凭据。代理只接受已登记的 session;这不是文章作者的真实 API Key,也不应把真实凭证放进文章或录屏。
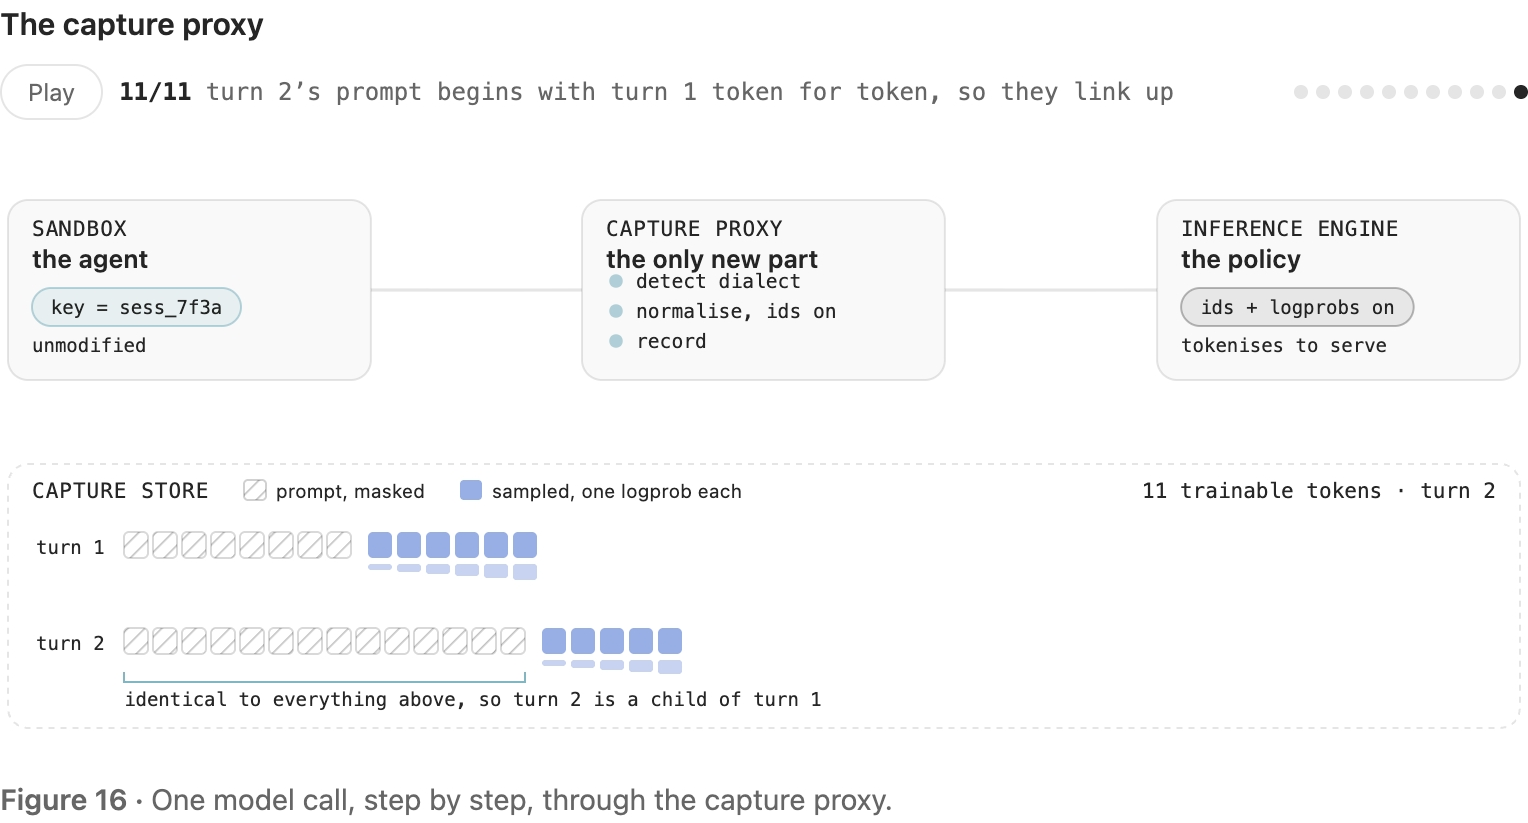
图中逐步经过的是一次模型请求,不是整道题。抓住“先取得完整输出并存档,再回放给调用方”。
它支持四类接口:OpenAI chat completions、OpenAI Responses、Anthropic Messages、Google generateContent。它们说法不同,底层都需要转换成训练器能消费的统一记录。
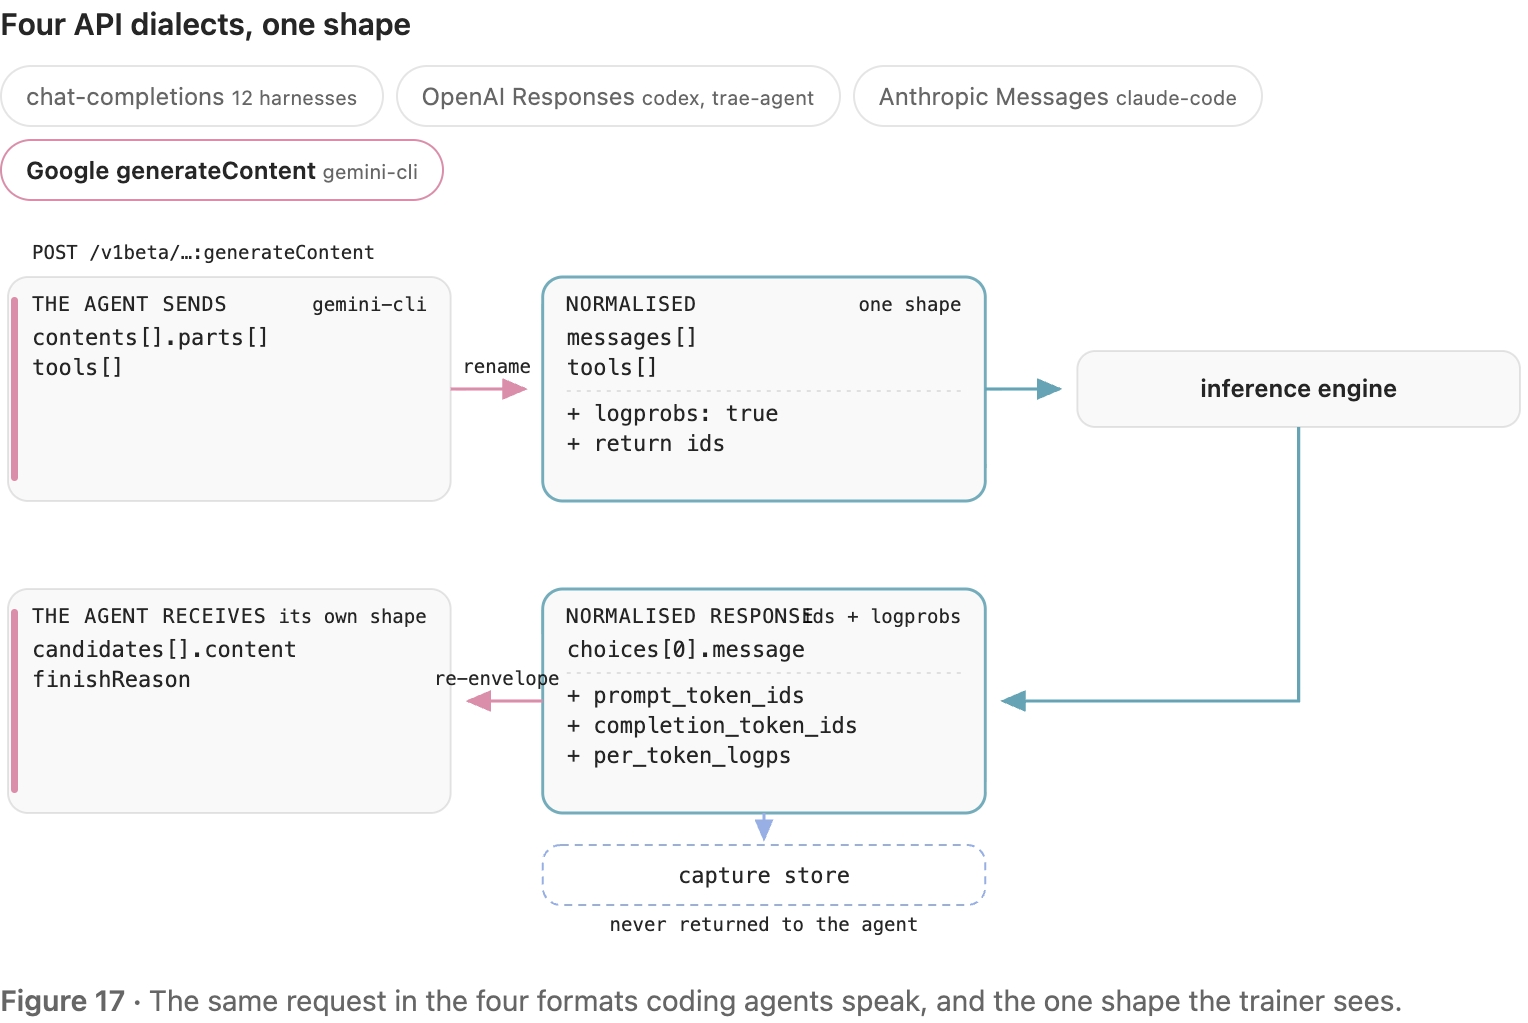
切换按钮可以观察同类请求的不同包装。统一结构不等于抹平各框架的所有行为差异;上下文管理和循环仍由原来的程序负责。
这套代理向推理引擎请求时不使用流式输出:等完整回答到达,存好记录,再向 harness 回放流。因此首个 token 的等待时间会更长。这是实现上的取舍,不能说“完全没有性能开销”。
为什么有的接口只能评测,不能用于这套训练
若只能取得可读文本,可以查看答案;若再有一些概率信息,仍未必满足训练合同。本文实现要求精确的 prompt token ids、生成 token ids 和与生成对齐的 logprobs。
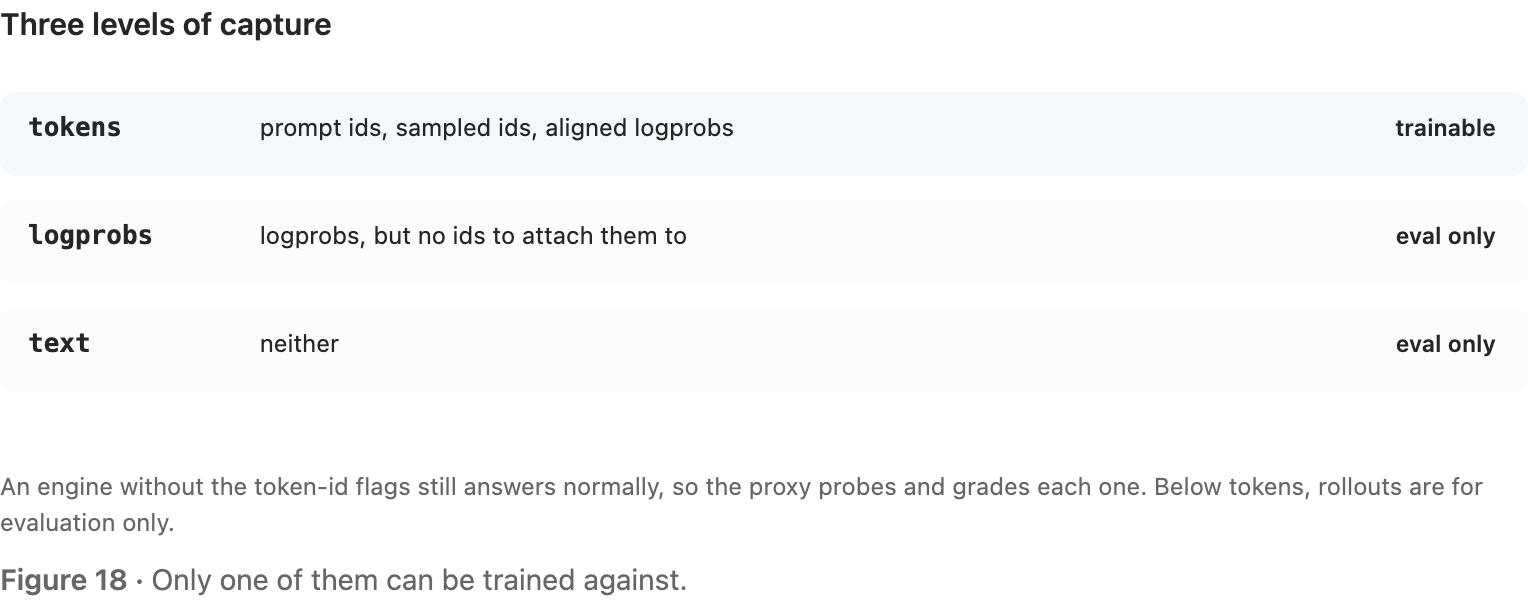
三层捕获图的重点是最高层才能作为这套训练的输入。Hosted API 仍可运行评测;只是达不到该实现的精确 token 要求,并不意味着这些服务不能以其他方式训练模型。
作者用 vLLM 的 token-id 返回及 processed logprobs 配置,并让采样分布与训练重算的分布对齐。top_p=1、top_k=-1 表示不按这两种方式截断采样分布。论文式推导可以很复杂,但基本要求很朴素:你声称学习的是哪个概率过程,记录就要对应哪个过程。
作者报告,调整 top_p 后,他们的 importance ratio 从约 0.985–0.993 更接近 1,达到约 0.9984–0.9999。这是他们实现里的诊断结果,不是所有训练系统都必须达到的统一阈值。
多轮尝试为什么会长成一棵树
如果上一轮输出完整地出现在下一轮输入中,两次调用可以连接起来。但重试可能生成一个兄弟分支,子代理和压缩后的上下文可能开始一个新根节点。
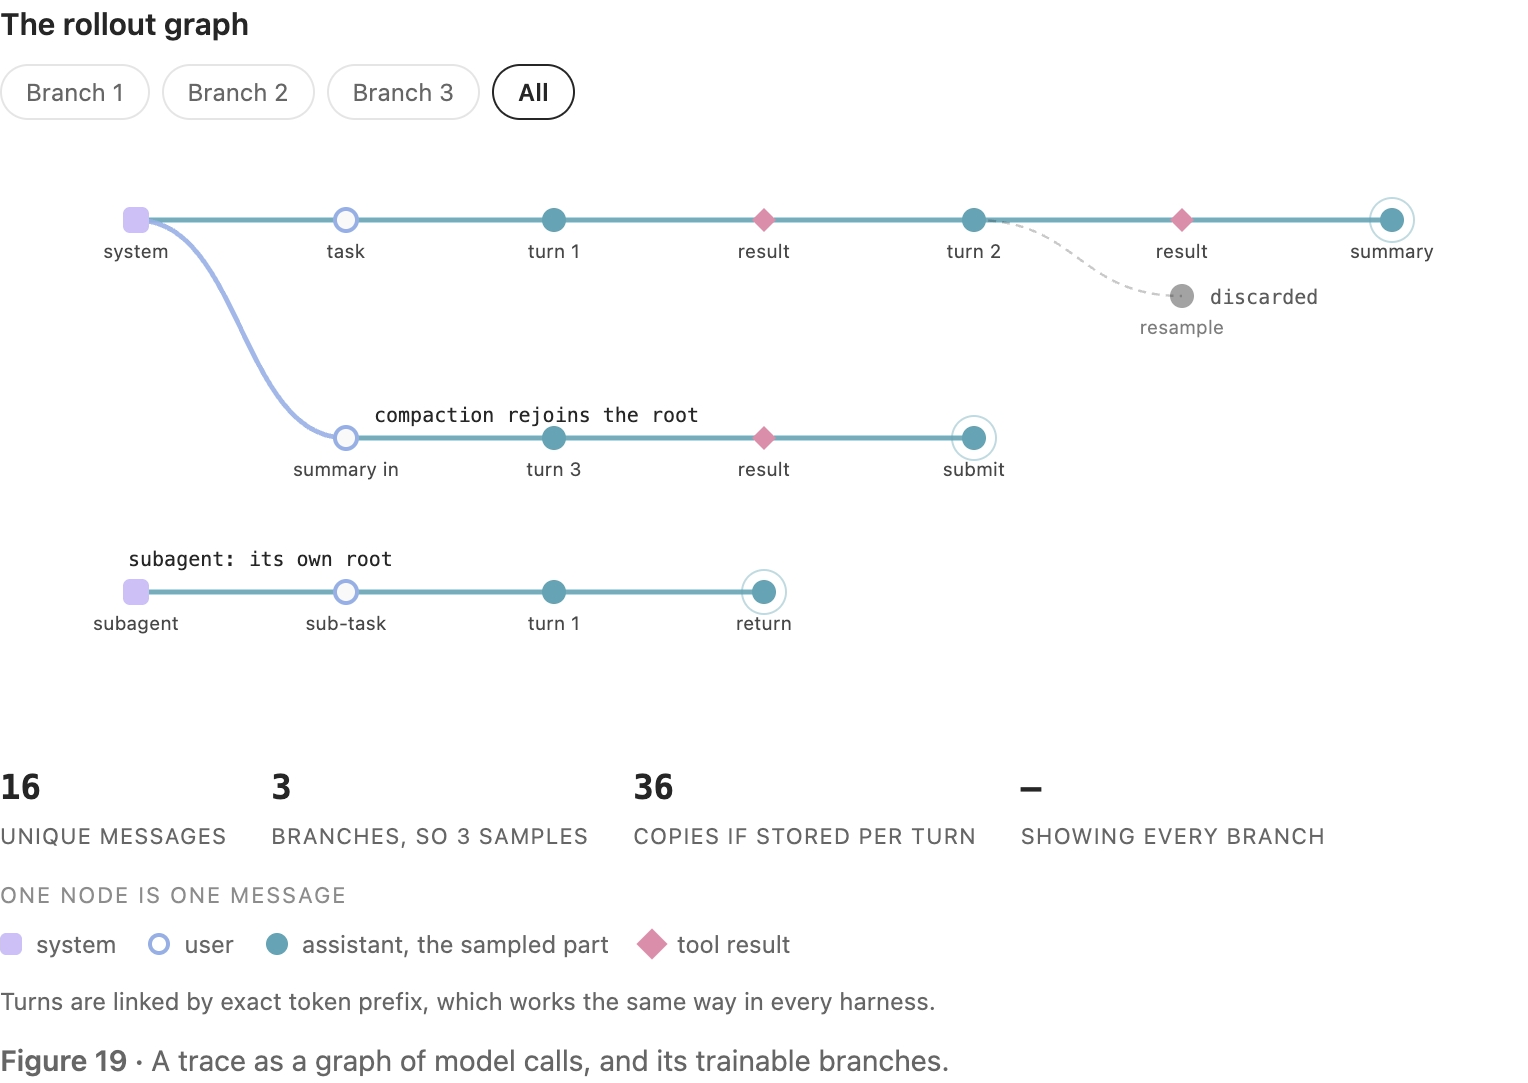
代理按精确 token 的最长前缀关系连接调用。从根到叶的一条路径,形成一个训练序列。看视频的分支按钮,理解它为何不是简单地把所有文字串成一根长绳。
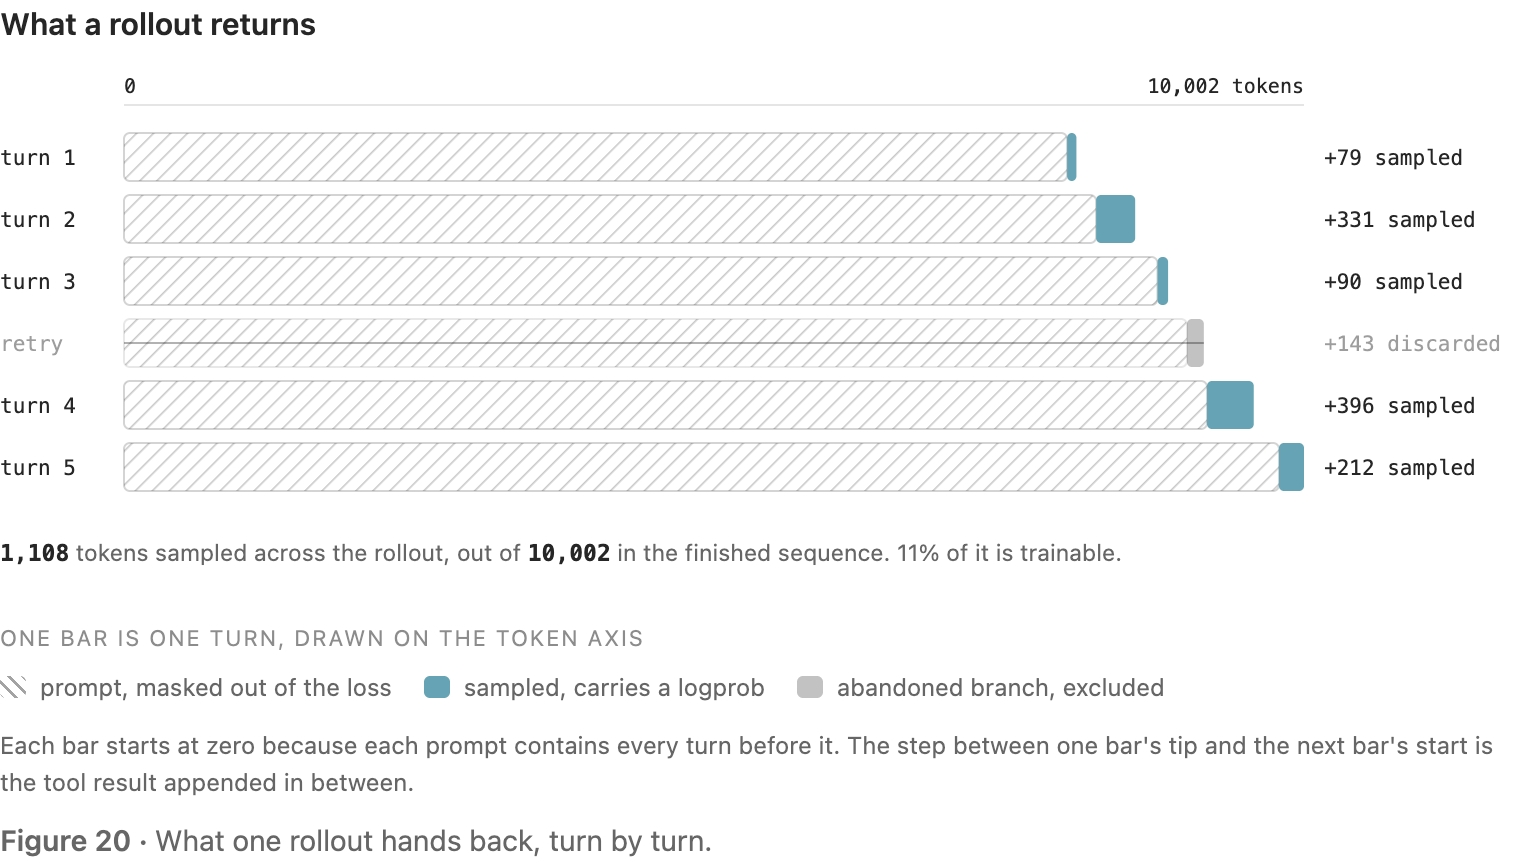
这张返回合同图说明 loss mask:外部上下文通常标 0,模型真正采样的目标 token 标 1。概率缺失或错位的回合可以保留作上下文,不能冒充可靠的训练目标。
这个区别相当于分清“题目纸上原来就写着的内容”和“学生自己写出的步骤”。训练目标需要知道哪部分是模型的行为。
六、一题怎么装进沙盒:读懂 Harbor 的六个文件
Harbor 把任务、运行框架、执行后端分开。一份题目目录不用预先写死用 Claude Code 还是 OpenCode;运行时才选择。
网页给出 SmolDataEnvs 的三个例子,每个例子展示六类文件。task.toml 描述任务配置;instruction.md 告诉智能体要完成什么;Dockerfile 准备运行环境;pull_bucket.py 获取任务所需数据;test.sh 启动评分;grader.py 实际检查答案。
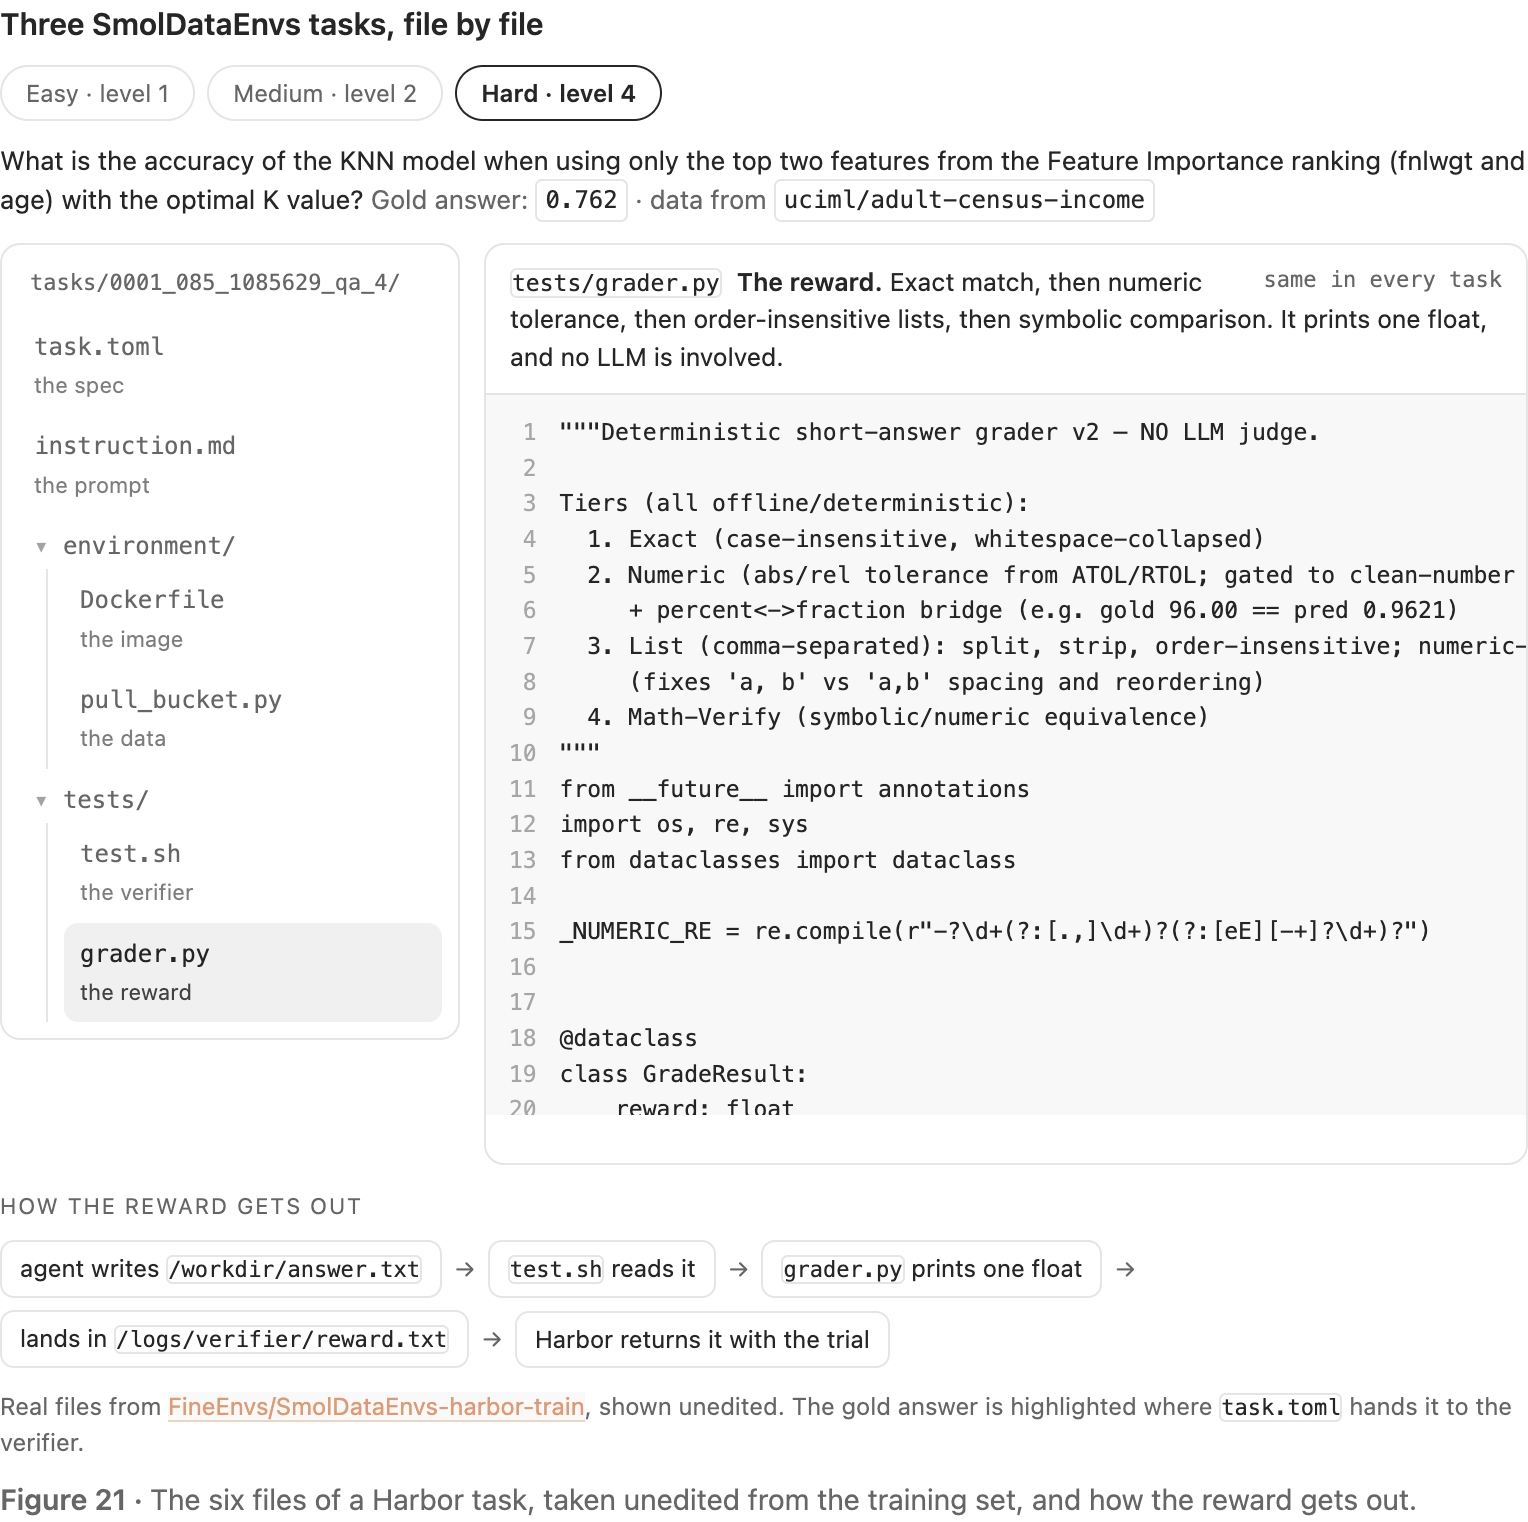
先切简单、中等、困难三个任务,再依次看文件。任务说明与评分程序应区分:模型应依据题目完成工作,最后由评分器检查结果。文件原文可能较长,本地源数据保留全文;视频演示页签切换,不假装逐页读完全部代码。
网页另外嵌入了一个全任务浏览器。制作时,这个外部 iframe 显示连接中断;因此这里保留不可用状态,不能提供它成功运行的录屏。读者可由文末原站自行进入。它与上面已成功录制的三任务模块是两个不同组件。
启动时做什么,每道题又做什么
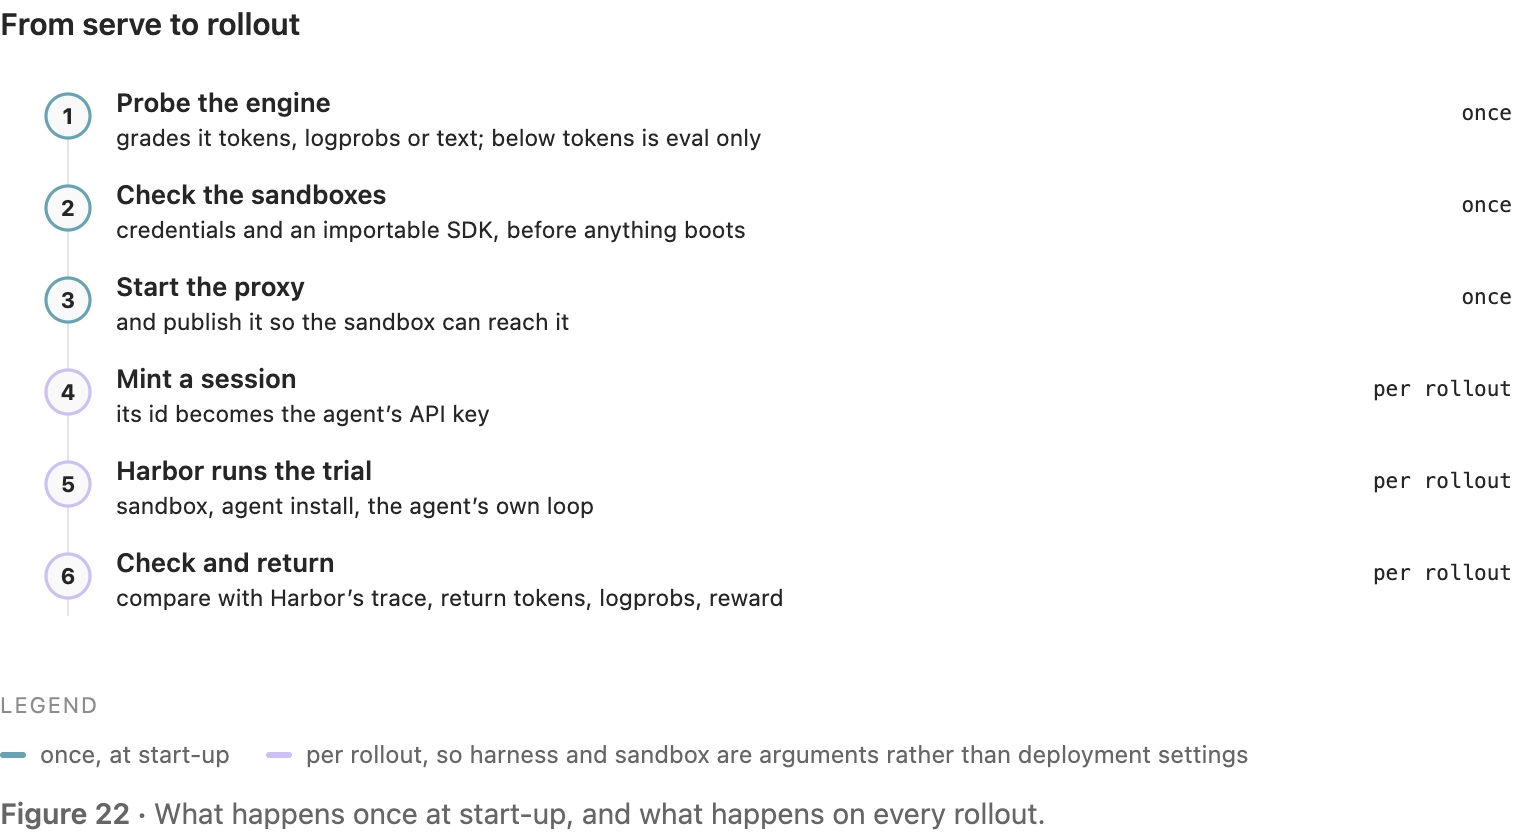
这张流程图把“一次启动”和“每次 rollout”分开。反复执行的尝试各自有沙盒和 session,不能用同一份混杂记录训练。
原文给出四个入口。info 检查本机准备情况,不启动任务;rollout 在没有环境服务器时直接运行尝试;serve 启动任务 API、网页界面与捕获代理;push 把环境服务器部署到 Hugging Face Space。
复现时一个很容易读错的参数是 -n 5:原文示例从 task-index 0 开始,运行任务 0 到 4 各一次,不是对同一任务采样五次。
本文没有执行这些训练、部署或付费沙盒命令。原文所述环境要求是当时的实现条件:TrainingTrace 路径需要 OpenEnv 0.7.0 或以后版本,Harbor extra 使用 Python 3.12;TRL worker 在原文 2026 年 10 月 1 日的快照中位于 main 的 experimental 路径。真正复现前应对照文末官方文档,不能把日期快照当成永久安装说明。
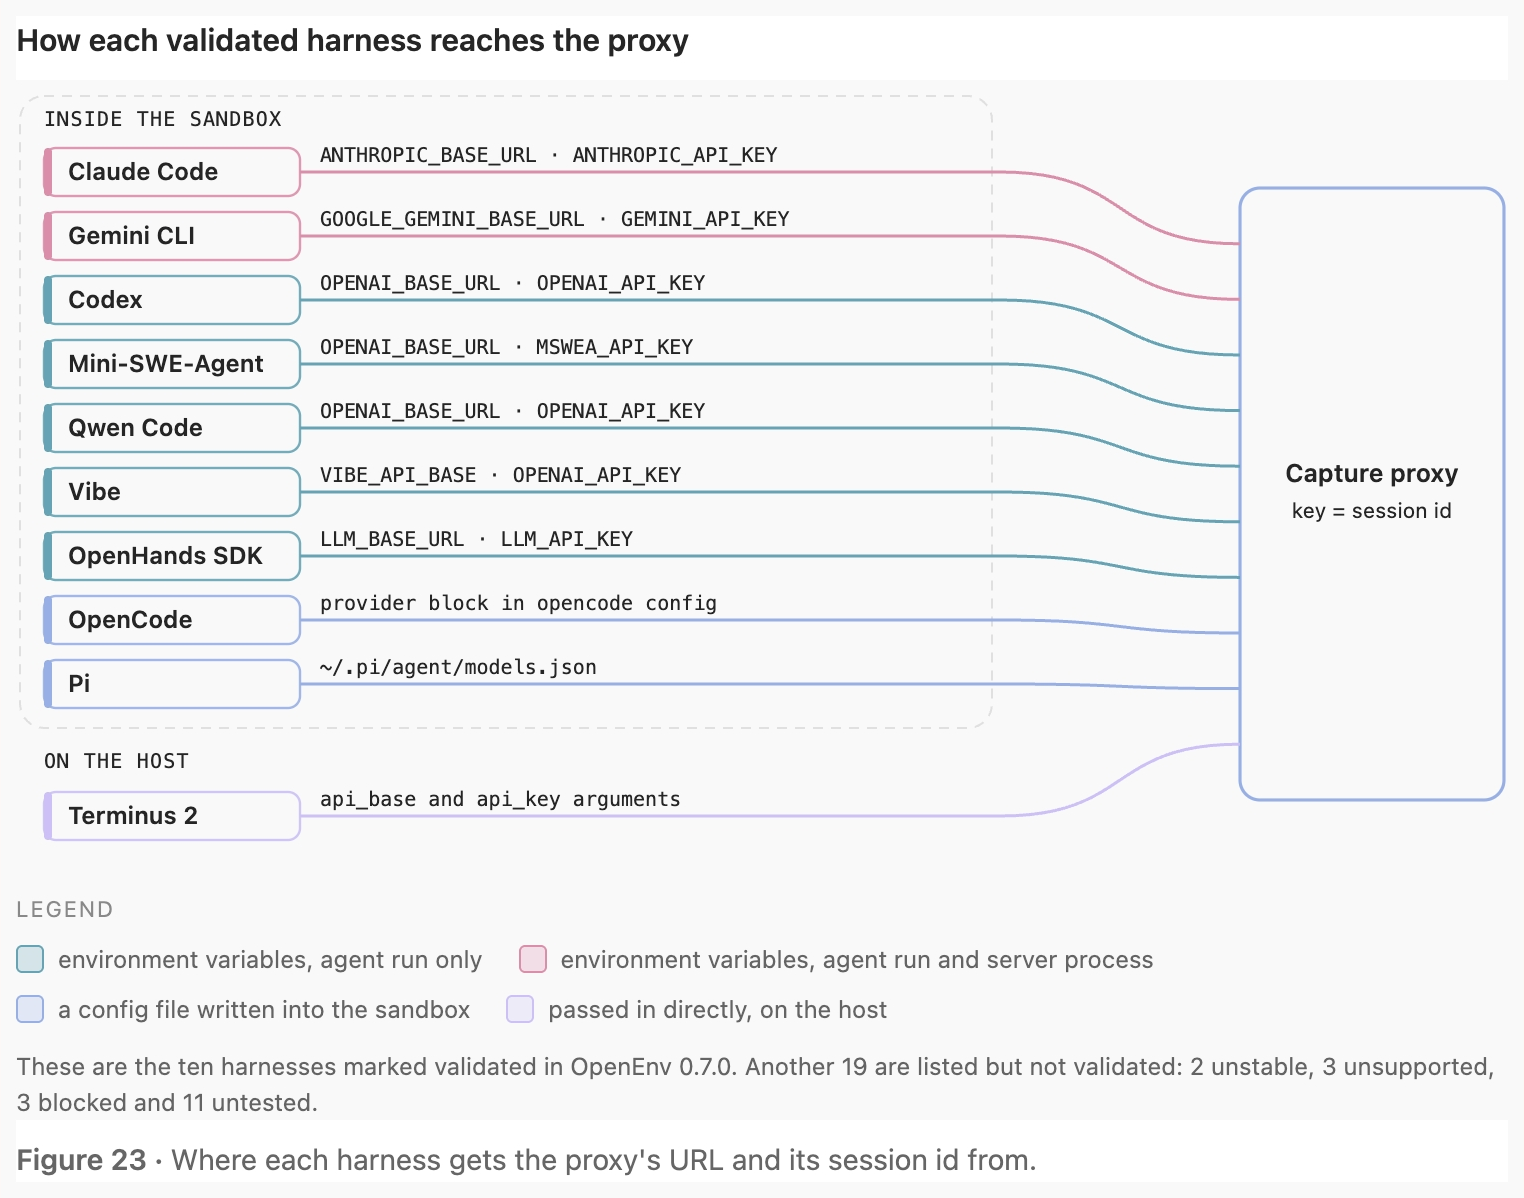
接线表列出不同 harness 从环境变量、配置文件或直接参数取得代理地址和 session 的位置。它支持的是接入合同检查,不能被读成“这些框架都参加了下文的四框架训练”。
工程上还有两条关键边界。
第一,沙盒失败与答错不是一回事。环境进程崩溃、评分器没运行,应返回 reward=None,不是粗暴地当作 0 分;否则模型会因基础设施故障受到错误反馈。
奖励还有一个实际反例:作者报告,一次较早尝试曾给“提交任何内容”加 0.2。策略学会立即提交,保留集准确率从 0.740 降到 0.178,训练奖励却看起来不错。这是原文用于说明奖励投机的独立早期案例,不能与本篇 LFM 主实验的 42%→54% 混为一组数据。
第二,HTTP 隔开执行端和训练端。作者先前把第三方智能体放在训练进程里,一个异常可能导致一个计算 rank 退出,其他 rank 卡在同步屏障。改为返回类型化失败值,有助于把任务失败与训练进程失败分开。
他们还将代理记录与 Harbor 自己写下的 ATIF 轨迹逐调用核对,检查回合数和输出 token 数。这是比“数据形状合法”更进一步的交叉检查,但本文没有独立重跑它。
规模扩大后还有容量问题:默认服务器并发上限是 4,小于一个 GRPO 组的 8 次尝试,训练前需匹配配置,否则会返回 CAPACITY_REACHED。作者的单进程代理约在 200 个并发 session 时健康检查开始饥饿,320 个时崩溃;这些是其运行条件下的观察,不能当成所有机器的容量规格。触及模型调用预算时由代理终止的最后回复,不会作为模型生成的训练数据。
部署也有边界:本地服务器分别为训练/网页接口与代理使用端口;部署到单端口 Space 时,代理挂在 /capture。原文说明沙盒不能附加私有 Space 所需认证头,因此该接入路径要求公开 Space,同时用已注册 session 和管理员凭据保护访问。本文只解释设计,未部署服务,也未传入任何凭证。
七、真正的实验:小模型、四种框架、同一套数据题
核心实验的模型是 LFM2.5-2.6B。2.6B 大约表示 26 亿参数;参数数量不直接等于能力,但说明作者研究的是可自行训练的较小模型。
训练题库来自 SmolDataEnvs。作者选取 1,000 道训练任务,其中 400 中等、600 困难,使用固定顺序。测试集有 250 道保留任务,与训练集在 notebook、问题和指令层面做了隔离。
测试使用 Claude Code、Codex、OpenCode、Mini-SWE-Agent 四种 harness。250 道题乘以 4,就是 1,000 个“任务—框架”评测格。起始基线只有 998 个格取得评分,因此其分母与后续的 1,000 不完全相同。
Pass@1 在这里指首次取得评分的尝试是否成功。它不是让模型反复试到成功,也不是训练中八次采样的总成功概率。每隔 100 个训练步进行一次评测。
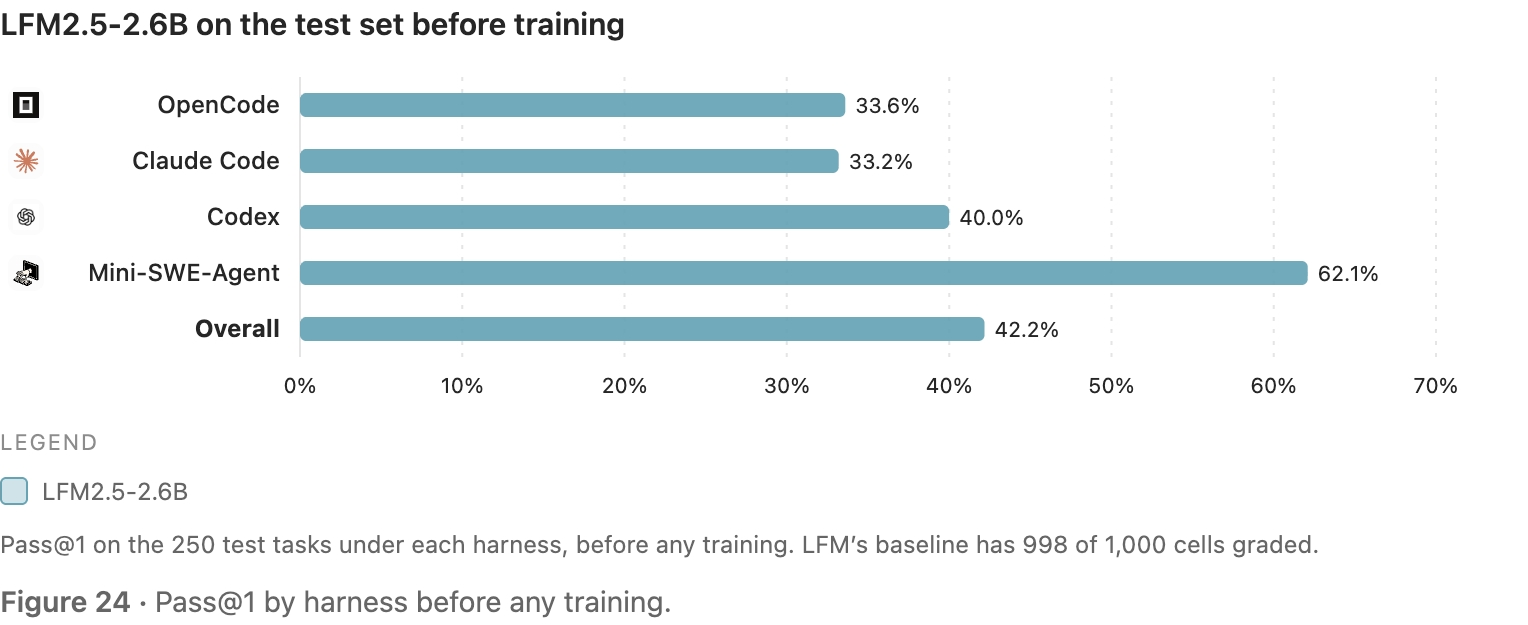
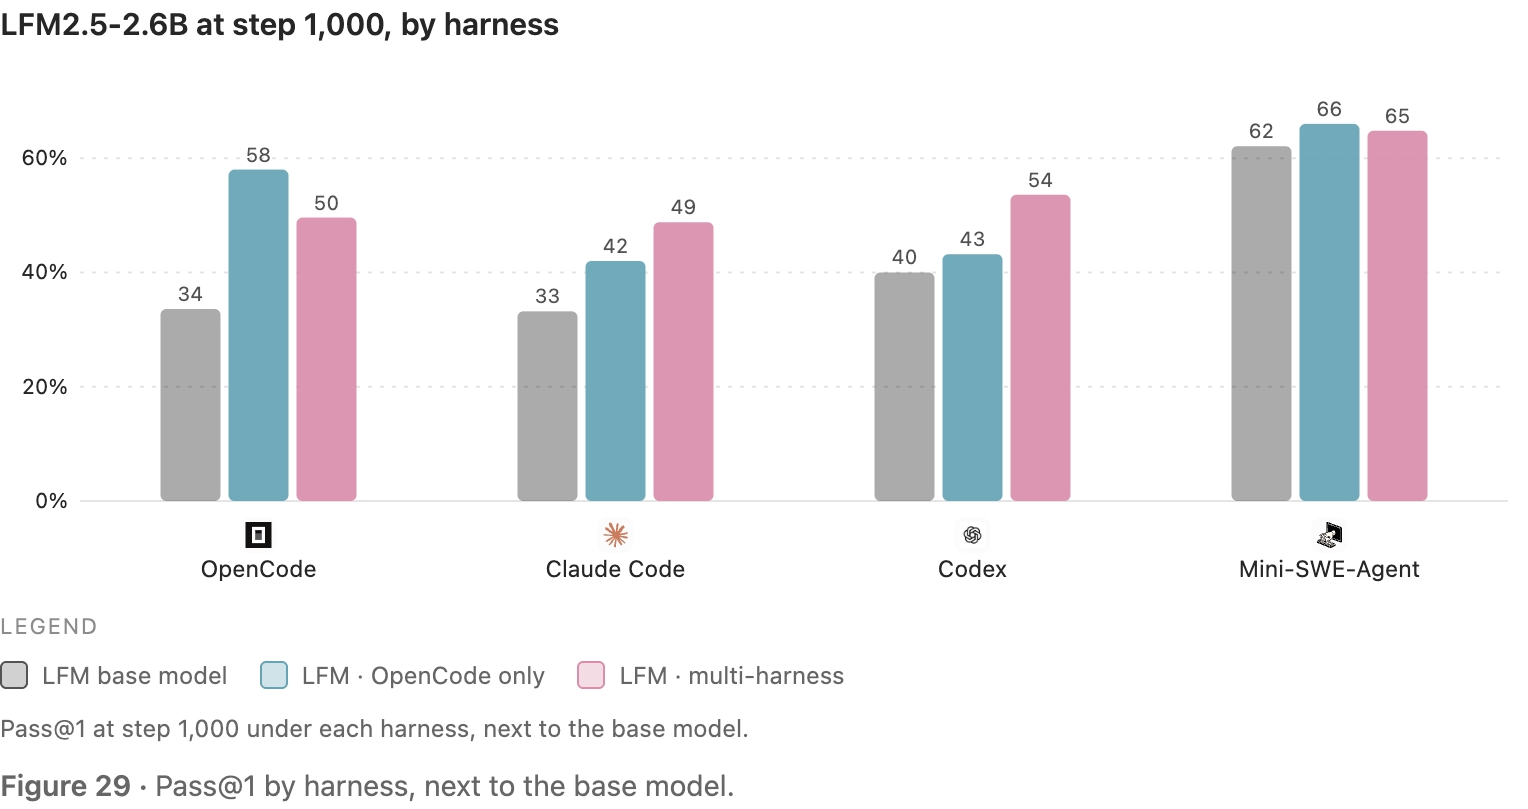
起点图显示同一基础模型在各框架上的分数已经不同:OpenCode 约 33.6%,Claude Code 约 33.2%,Codex 40%,Mini-SWE-Agent 约 62.1%。这说明“模型自身能力”并不能单独描述完整系统的成绩。
GRPO 为什么要一题做八次
GRPO 可以理解为:对同一道题做一组尝试,比较组内结果,用相对反馈更新模型,而不只是给一个答案孤立打分。
这次每组有 8 个 rollout,同组用相同的任务和相同的 harness。单框架组只用 OpenCode;多框架组每组使用四种 harness 之一,按组分配,但不会在同一组里混入不同 harness。这样组内比较尽量反映行动差异,而不是把框架差异直接当成优势。
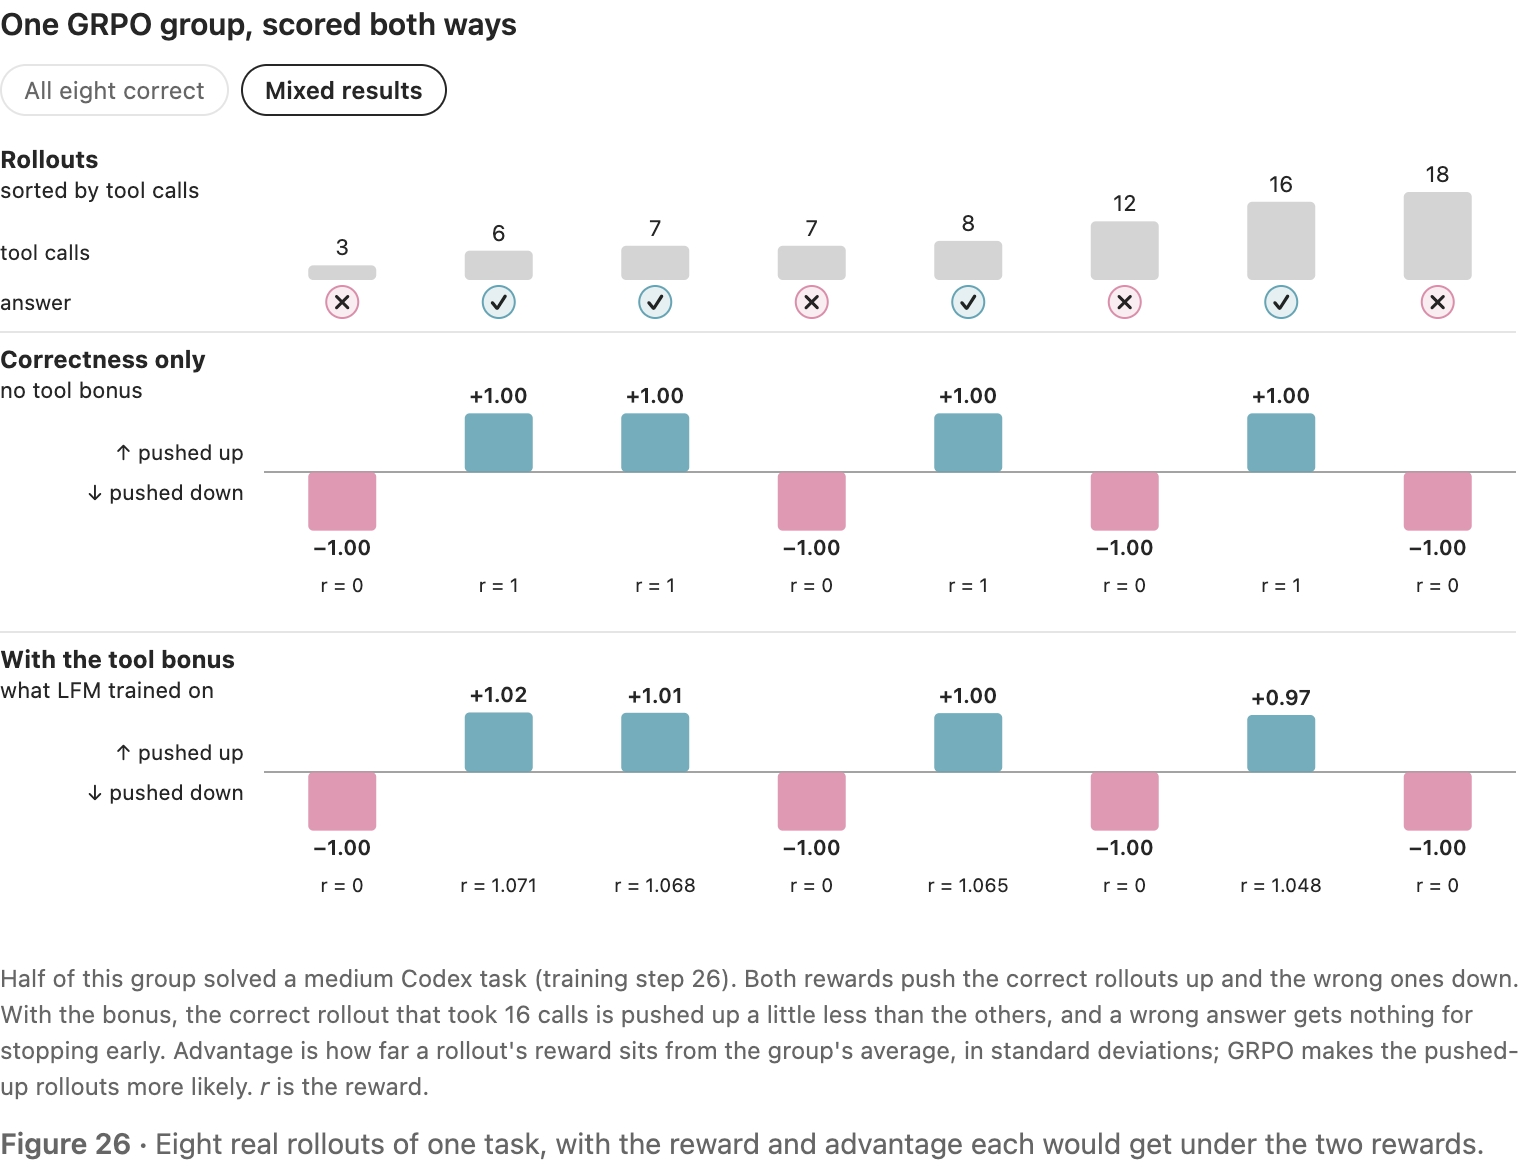
切换“全部做对”和“有对有错”,观察组内反馈为何不同。如果奖励只有 0/1,而八次都对,组内就难以区分好坏。作者加入了做对之后的工具效率奖励。
奖励规则是:答错为 0;答对时为 1 + 1.5 / (15 + 工具调用次数)。例如正确答案用 5 次工具,奖励是 1.075;用 15 次,奖励是 1.05。少调用工具只有在正确的前提下才获得额外收益。
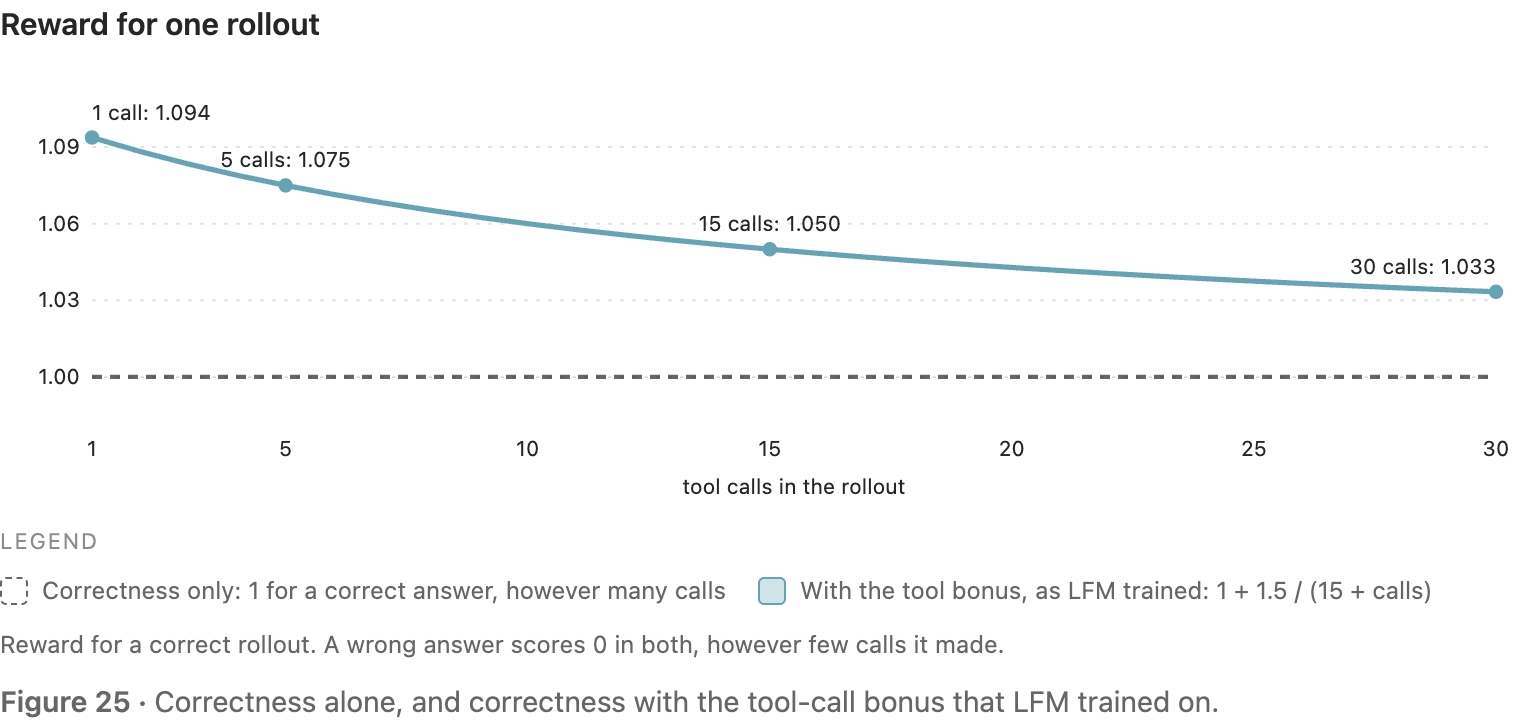
这张奖励曲线展示额外收益如何随调用数增多而变小。最高额外收益不超过约 0.1,不能说“效率比正确性更重要”。
它也让“全都做对但调用数不同”的组出现对比。作者对保留的更新组审计:单框架约 17.5%(97/555)的组属于这类,多框架约 22.6%(155/686)。这些分母是审计保留组,不是所有训练任务或所有尝试。
LFM 实验没有提供不加效率奖励的直接消融。因此,效率改善与这个奖励设计相容,但不能单独证明效率奖励造成了全部变化。
训练花费和暴露量:为什么不能只盯最终分数
作者使用两张 H100,一张训练、一张推理;沙盒用 E2B,配置 1 CPU、4GB 内存。单框架和多框架训练分别约 32 与 46 小时,不包括评测、排队和重启。它们不是完整账单。
异步生成通常比当前权重落后约 2 个更新步,最多约 4 步。保存行为概率,就是为了正确处理这种时间差。
两个训练组接触的内容并不完全相同:单框架覆盖约 555 个不同任务、多框架约 626 个;监督目标 token 约 12.5M 与 18.7M,总处理 token 约 162M 与 451M。M 表示百万。
有些框架的历史重写还会影响一段轨迹转换成多少训练行。Claude Code 在相关记录中约形成 8 行,其他框架约 1 行。因此,轮流选择四种 harness,并不自动意味着四者得到相等的训练 token 权重。
八、结果怎么读:准确率、泛化、效率是三个问题
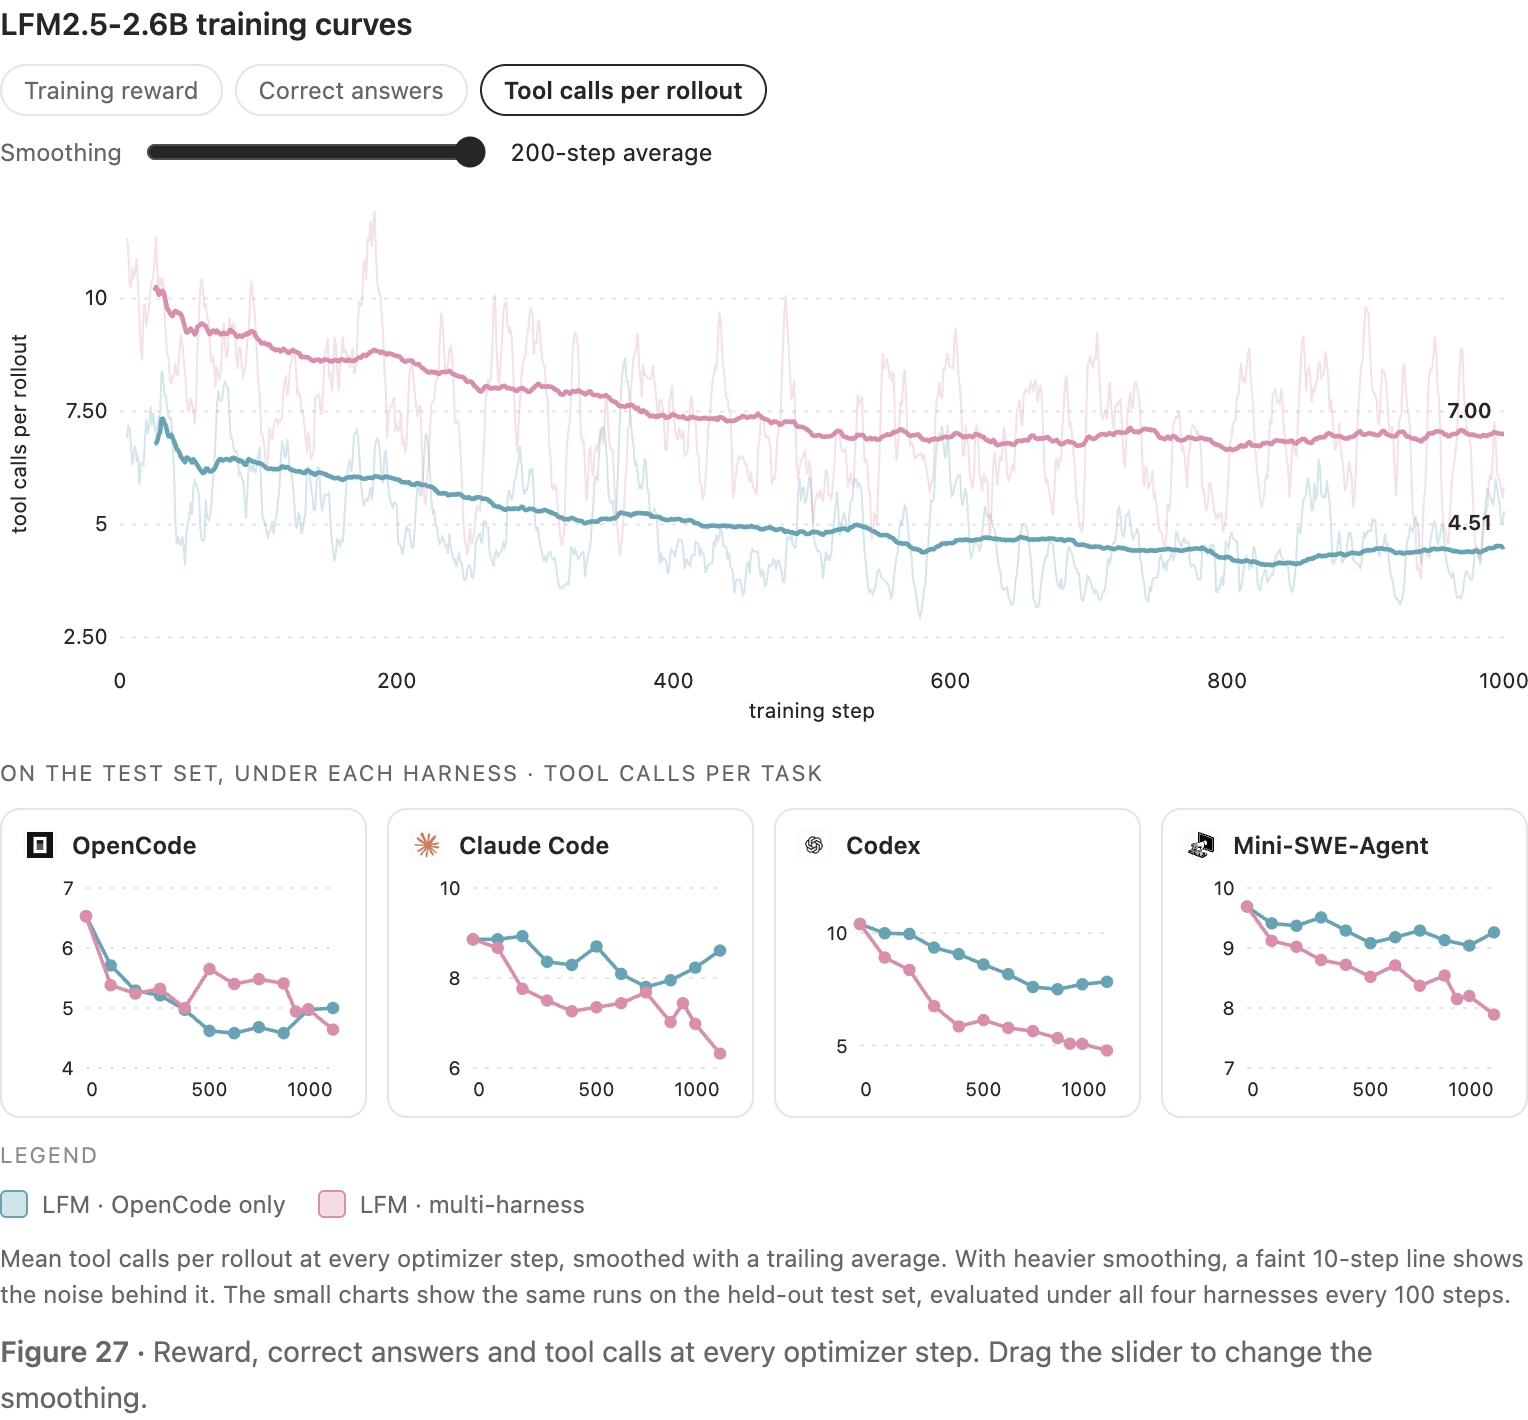
训练曲线有奖励、正确率和工具调用三种视角。视频切换指标;另一个短视频操作平滑窗口。平滑只是帮助看趋势,不会增加样本量,也不会把噪声变成确定结论。
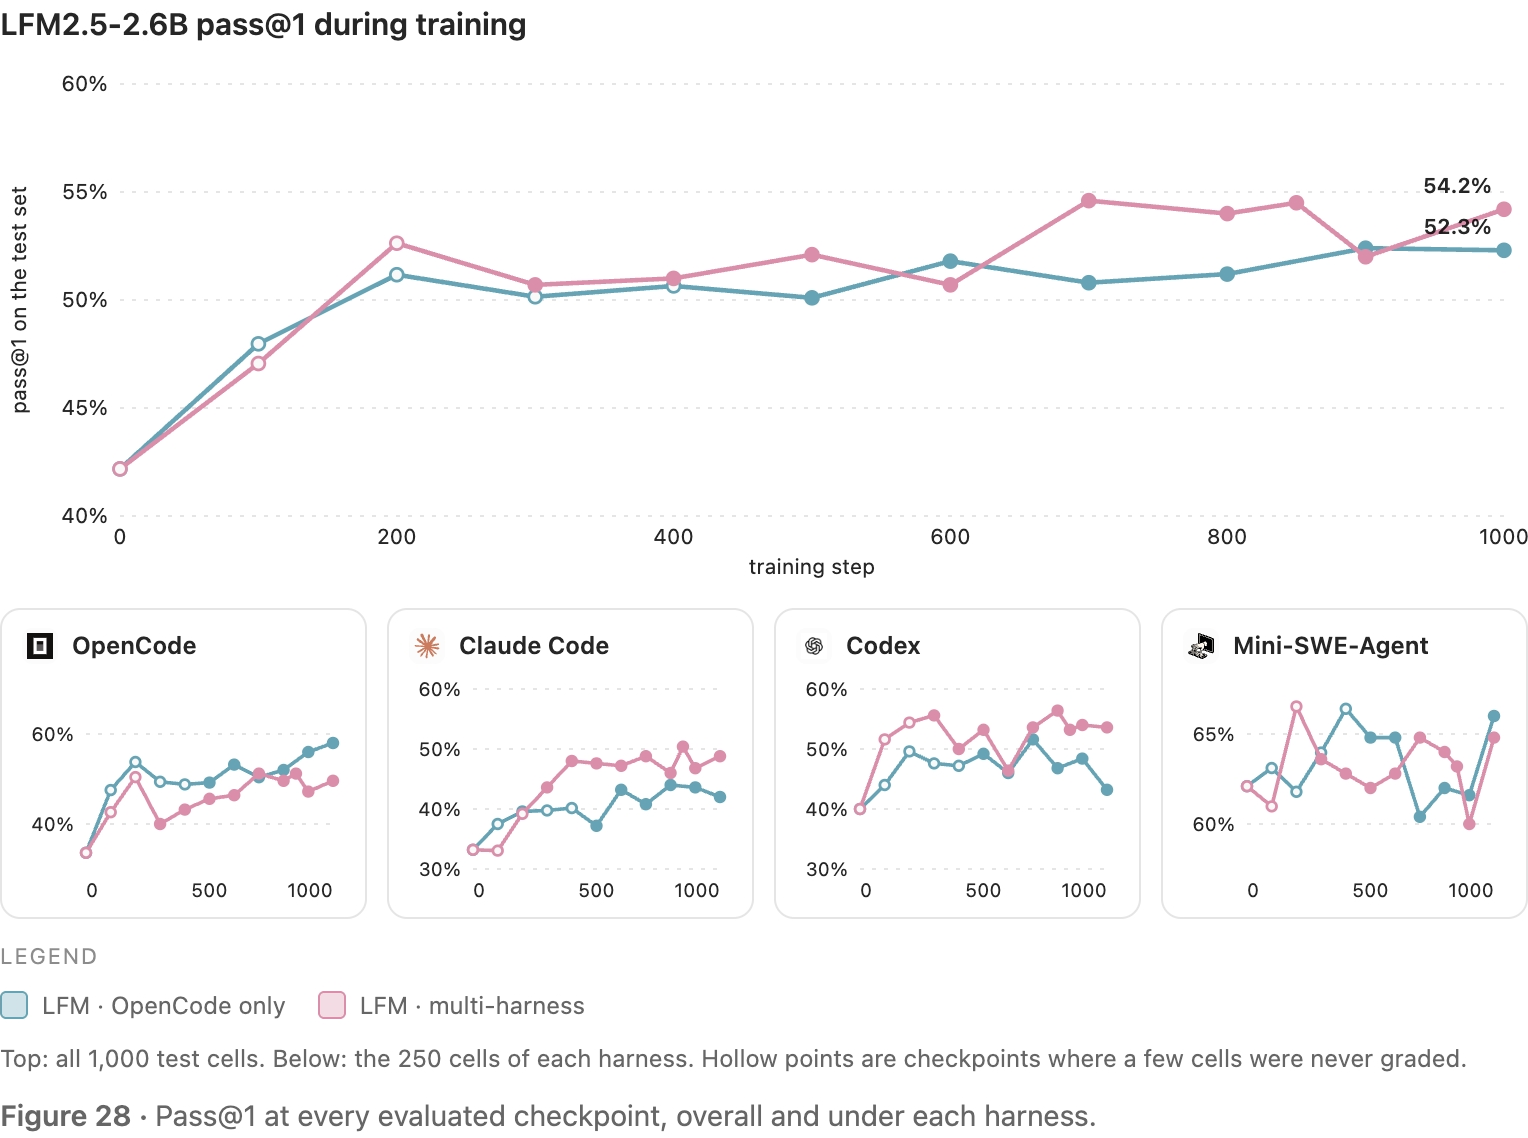
测试曲线回答“保留任务做得怎样”,与训练曲线回答的问题不同。训练奖励增长不能替代测试准确率增长。
训练到第 1,000 步,整体准确率是单框架 52.3%、多框架 54.2%。基础模型约 42.18%,相对于起点分别提高约 10.1 和 12.0 个百分点。
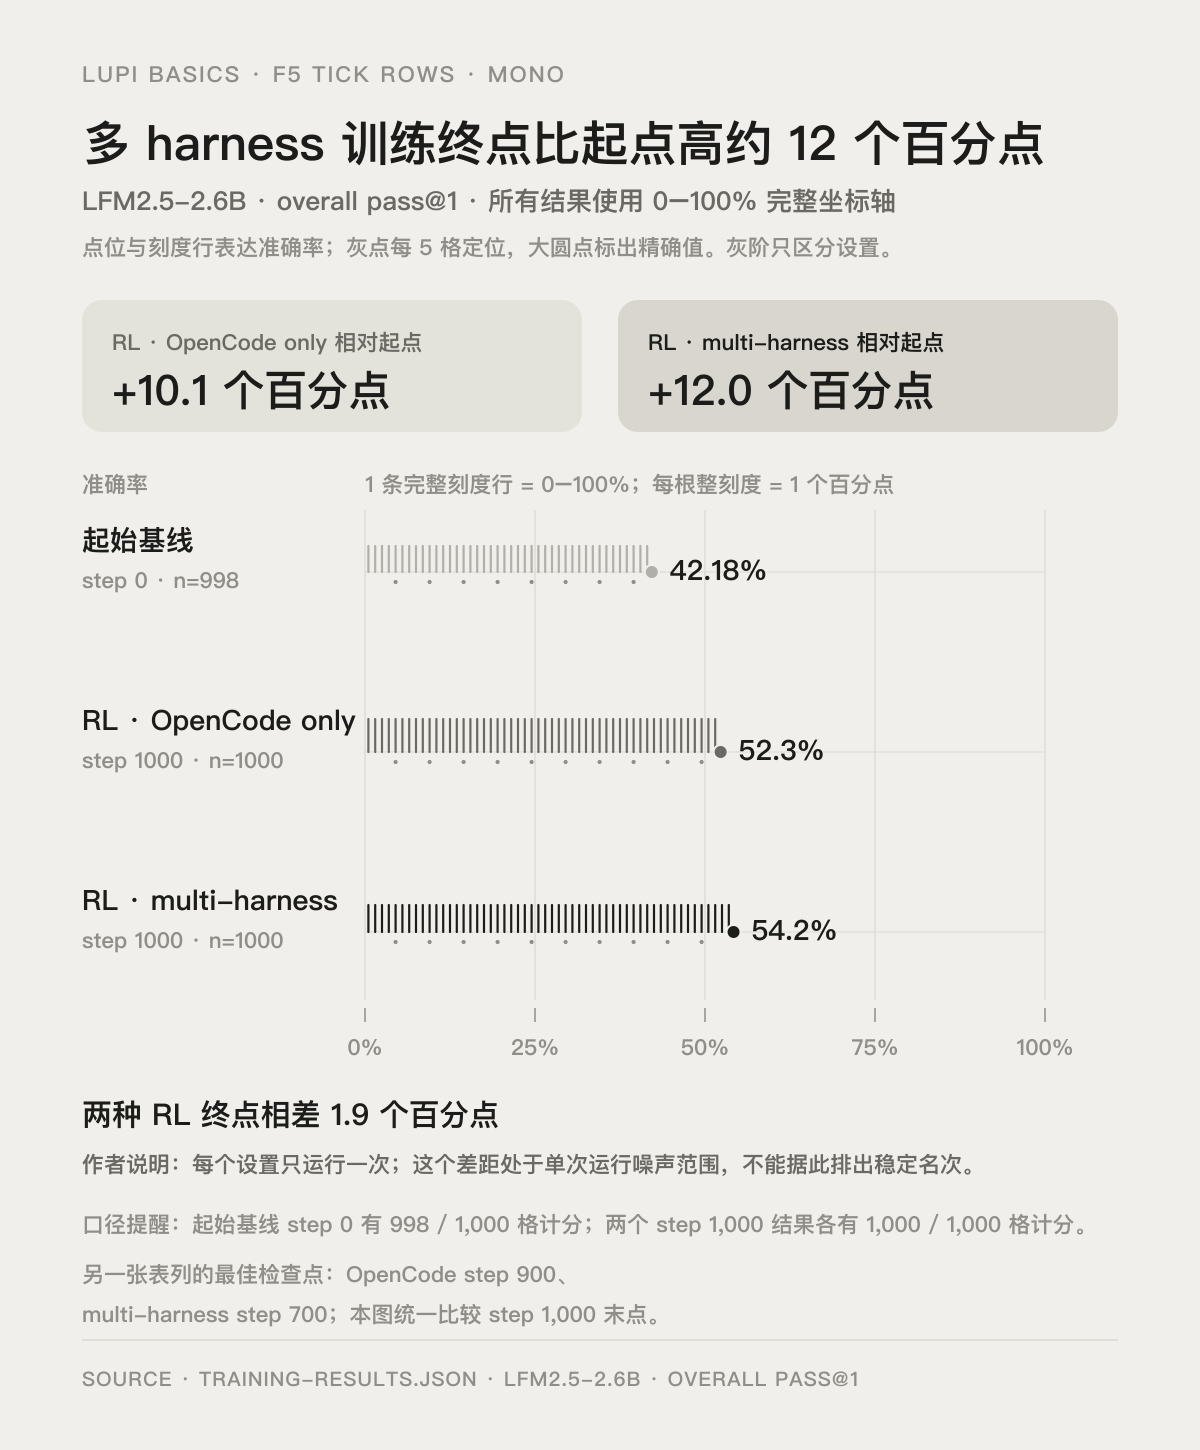
这是本地新增解释图,使用公开 JSON 中第 0 步与第 1,000 步数据,坐标轴完整保留 0–100%。它帮助分清“相对起点的改善”和“两种训练之间的差距”。
42.18% 到 54.2% 是增加约 12.0 个百分点,不是相对增加 12%。两种 RL 相差 1.9 个百分点,每种设置只跑一次,不能把它写成经过统计证明的稳定胜出。
原文更值得注意的是各 harness 的变化:多框架训练在四者上都有改善;只在 OpenCode 中训练,改善更多集中在见过的框架。对这些特定实验而言,跨框架表现是支持作者方向的证据;它还不是对没见过的新框架的普遍迁移证明。
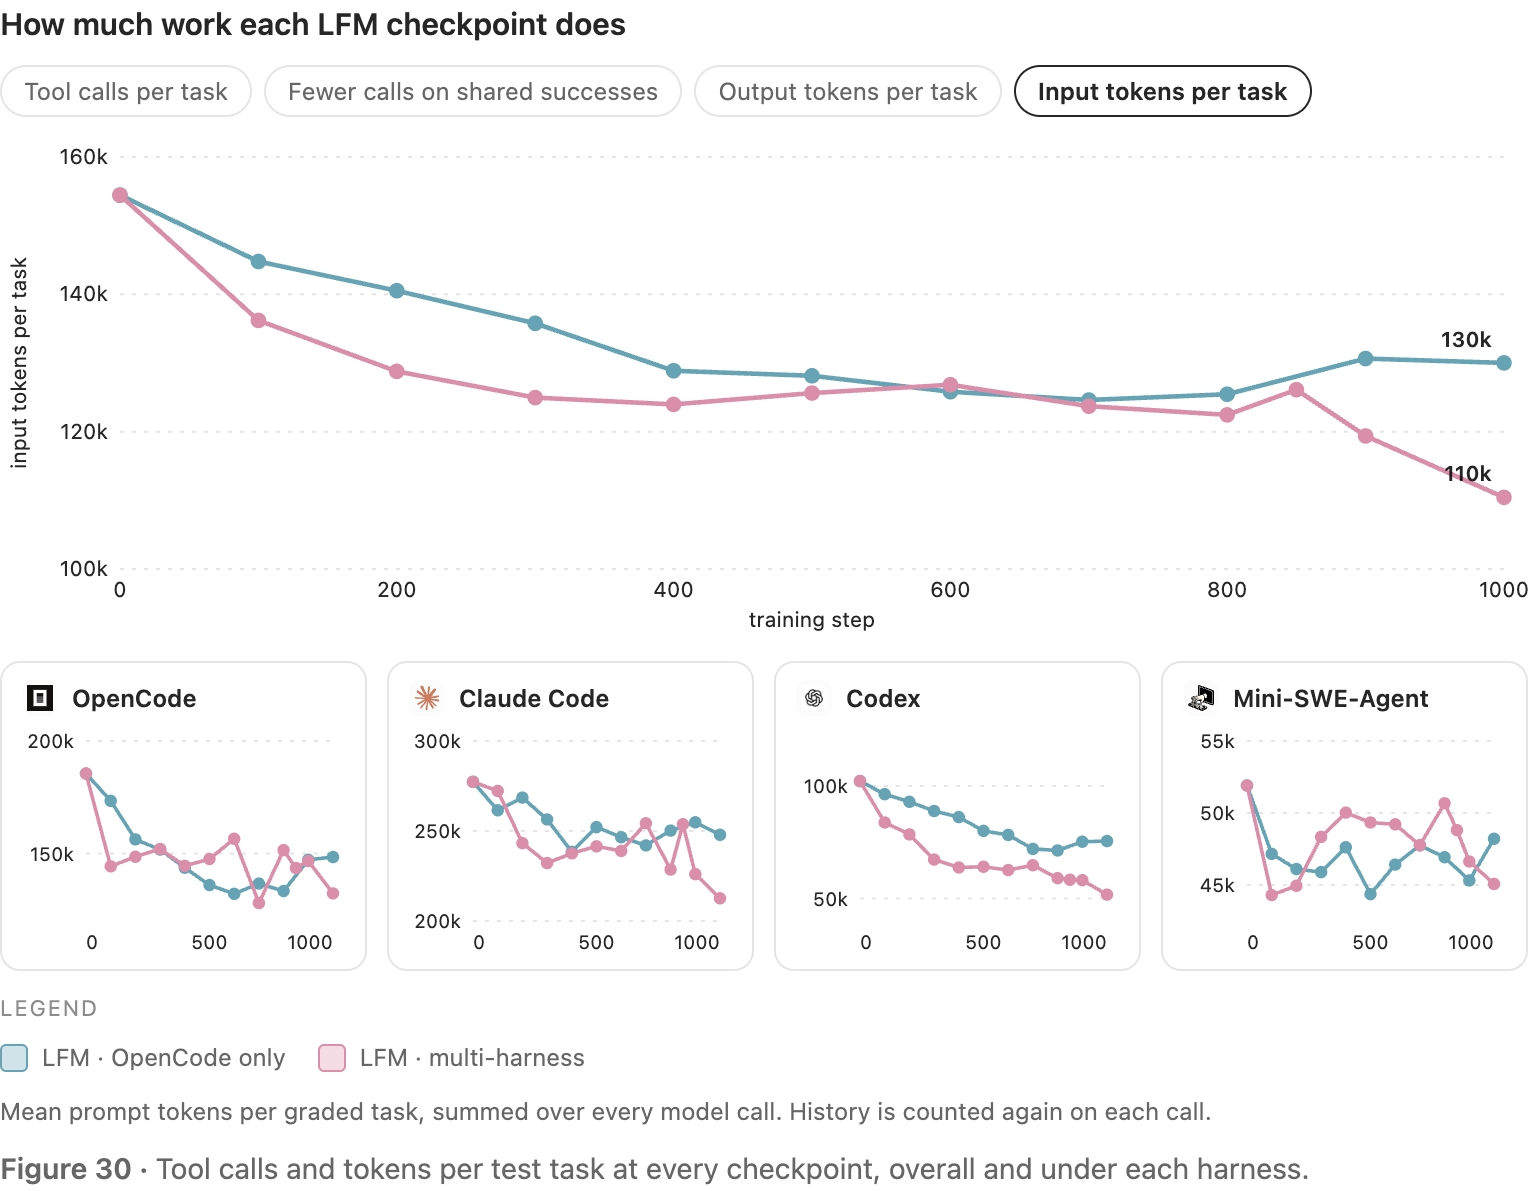
效率图切换四个指标。尤其注意“共同成功任务”这一项:作者在基础模型与训练模型都做对的格子上比较工具数,减少了“后来做对了更多难题,所以平均调用变多”的混杂。
多框架模型在这类共同成功任务上平均少用约 31.1% 的工具调用,单框架约少用 11%。这不是所有测试题都节约 31%,不是运行时间节约 31%,也不是 API 账单节约 31%。
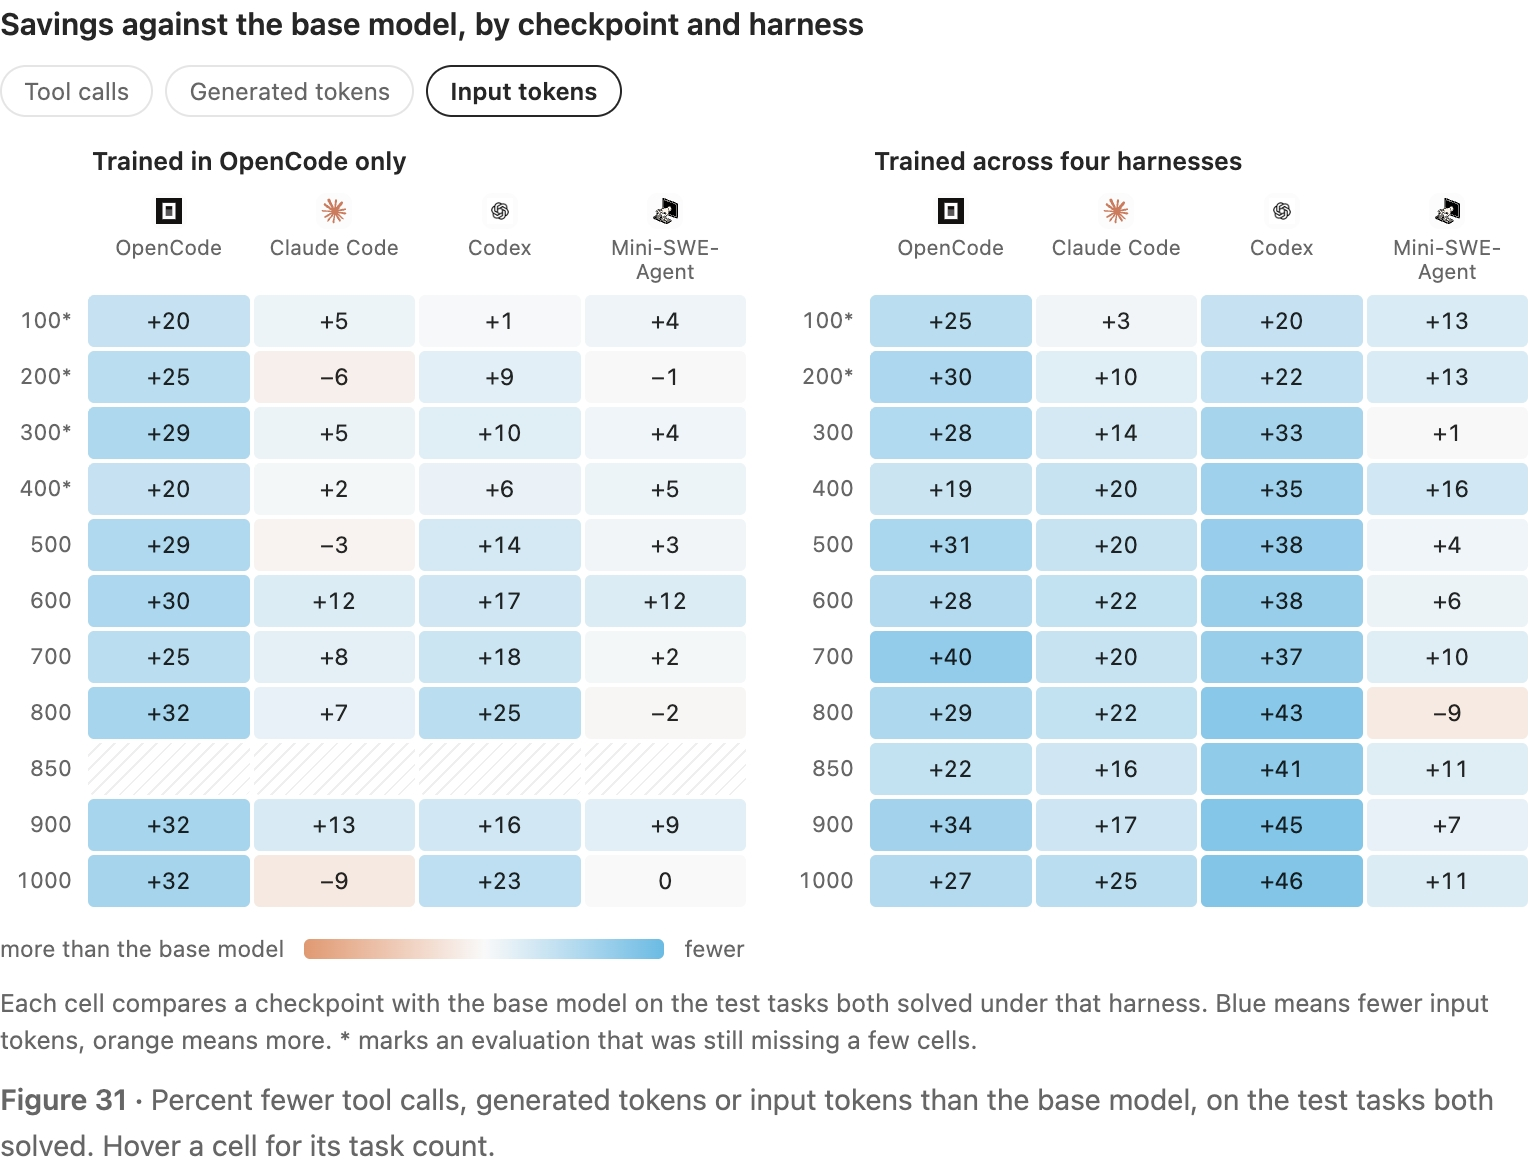
热图把不同 harness 的工具调用、生成 token、输入 token 改变分开。生成 token 是模型写出的内容;输入 token 包括它读到的历史和工具结果。省了一种,不保证另外两种按相同比例下降。
真实费用还取决于模型单价、缓存、机器利用率和沙盒成本。本文数据支持工作量指标的变化,不能把这些数直接换成金额。
九、照着老师的成功解法学,为什么没有同样好
作者用较大的 Qwen3.8-27B 当教师,每个任务—harness 最多尝试 3 次,保留第一个正确 rollout,得到 3,189 条成功轨迹,覆盖 888 道任务:377 中等、511 困难。
只用 OpenCode 的子集有 801 条 rollout,转换成 4,825 个训练样本;多框架全部轨迹转换成 17,929 个样本。它们的轨迹数量、样本数量和 token 数不是同一个指标。
SFT 使用学生自己的聊天模板,全参数微调两轮,学习率 3e-6,有效 batch 8。训练时间约 1.5 与 6.5 小时,不含采集教师轨迹的成本。监督目标 token 约 1.2M 和 8.2M,也与 RL 的 12.5M、18.7M 不相等。
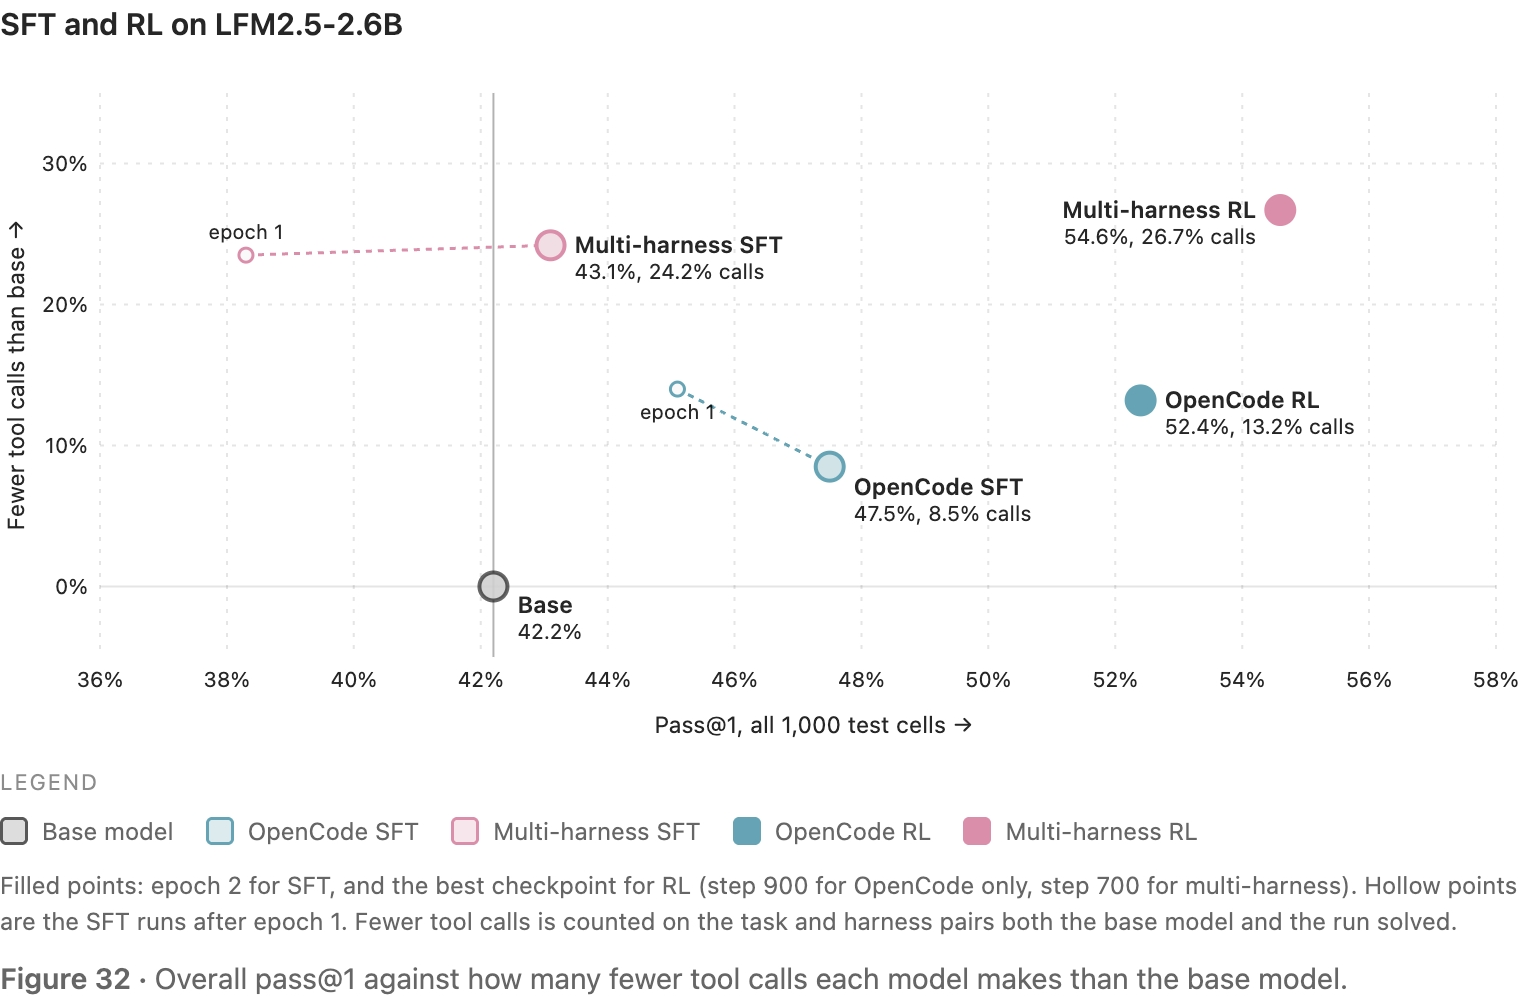
SFT 与 RL 对比图不能被读成严格等预算的算法擂台。这里同时改变了数据生成方式、目标函数、数据暴露和计算量。
在第 2 轮 SFT 终点,单框架整体约 47.5%,多框架约 43.1%。多框架 SFT 在 Mini-SWE-Agent 上从基础约 62.1% 降到约 45.2%;原文没有确立单一原因,不应该用“灾难性遗忘”四个字代替证据。
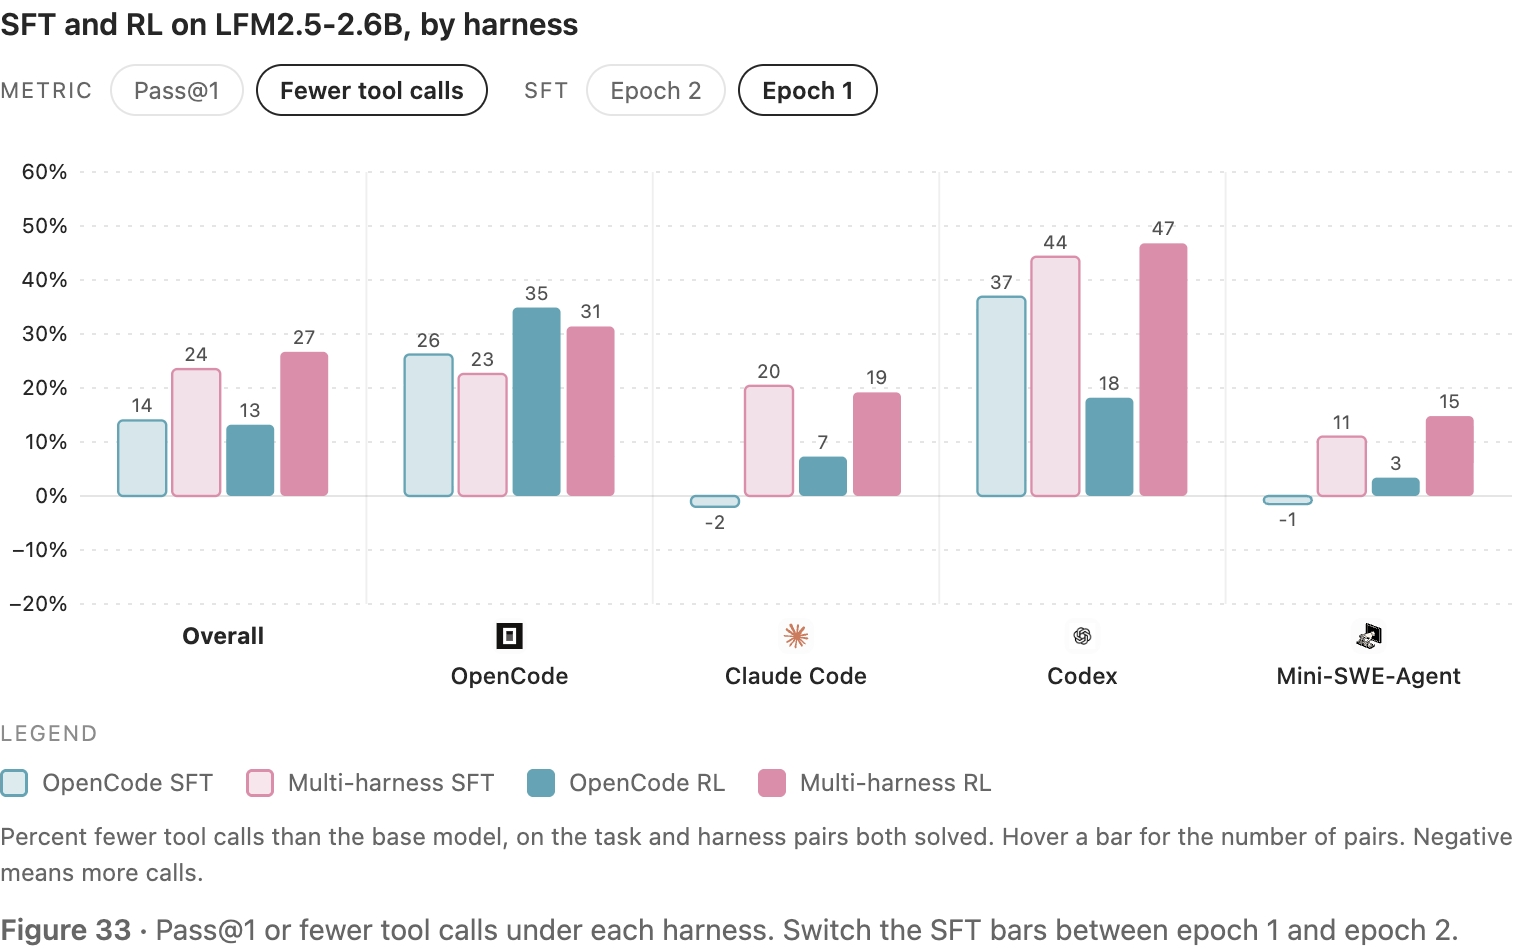
视频切换 Pass@1、工具节约以及第 1/2 轮结果。按相同口径看不同阶段,避免只挑最好的一张图。
还要留意,SFT 对照页面引用的 RL 最佳检查点,分别是单框架第 900 步 52.4%、多框架第 700 步 54.6%;前一节训练终点是第 1,000 步 52.3% 和 54.2%。两套数字都来自原始数据,但回答不同问题,不能混写。
最佳检查点从同一测试序列里选择,会产生选择偏好;没有独立验证集替你选它。再加上单次运行和预算不等,这组结果支持“在本设置下 RL 更有帮助”,不能推出“RL 在所有条件下优于 SFT”。
SFT 也可能改善效率:作者报告多框架共同成功任务上的工具调用减少约 24.2%,单框架约 8.5%。准确率和效率不是同一个排名。
十、不能省略的失败实验:Qwen 为什么先涨后跌
原网页把较早的 Qwen3.5-2B 实验放在折叠区。它对理解这项工作非常重要:成功方案并不是一次就顺利出现。
这轮使用 1,000 道训练题,150 简单、600 中等、250 困难,奖励只看正确性。基础模型四框架平均约 14.6%,独立运行约 15.9%,与 LFM 的起点不能直接当成同一个任务配置下的模型排行。
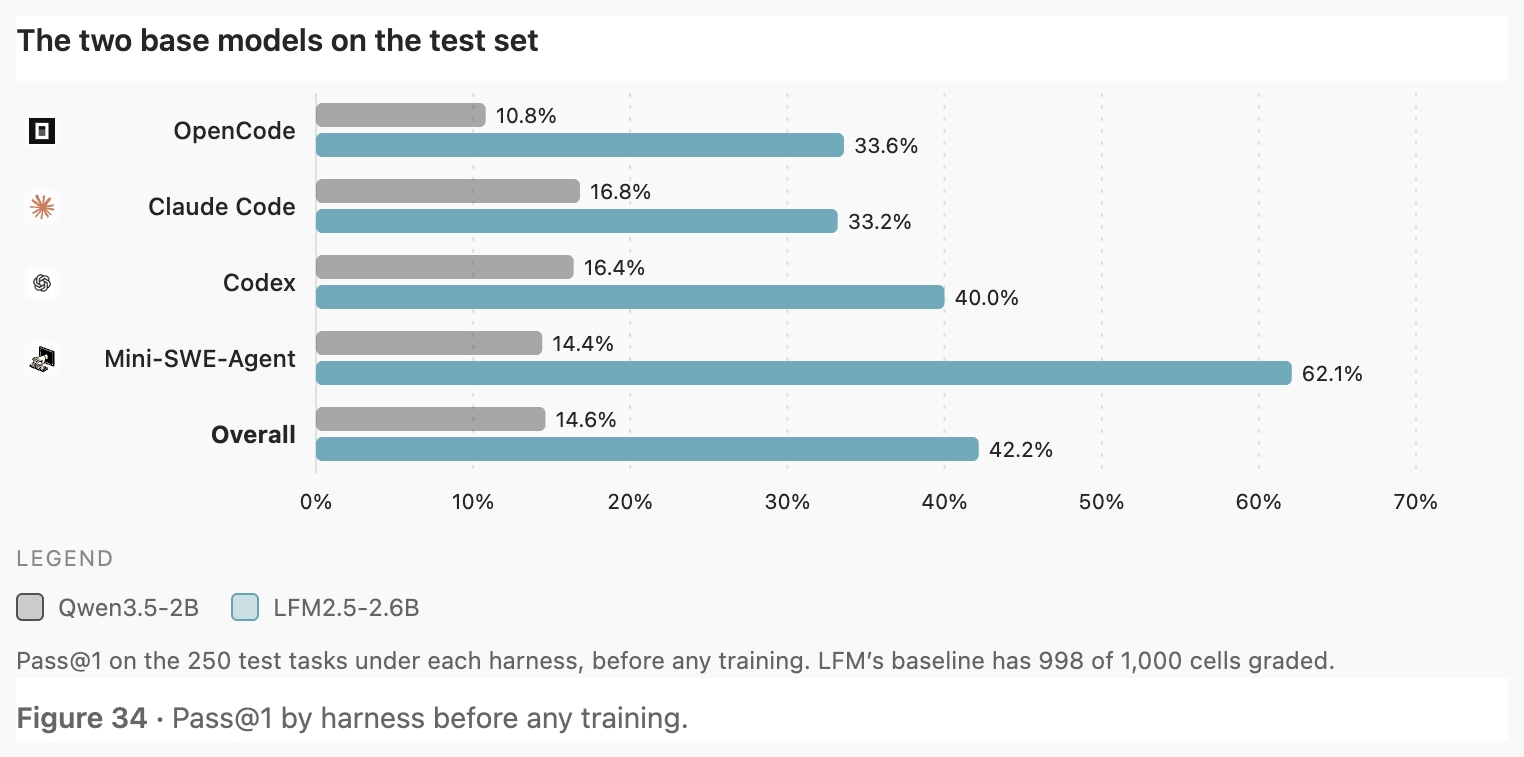
基础能力对比图提醒读者,两种模型的起点不同。后续配方也不同,不能把后来的改善全部归因于换了模型。
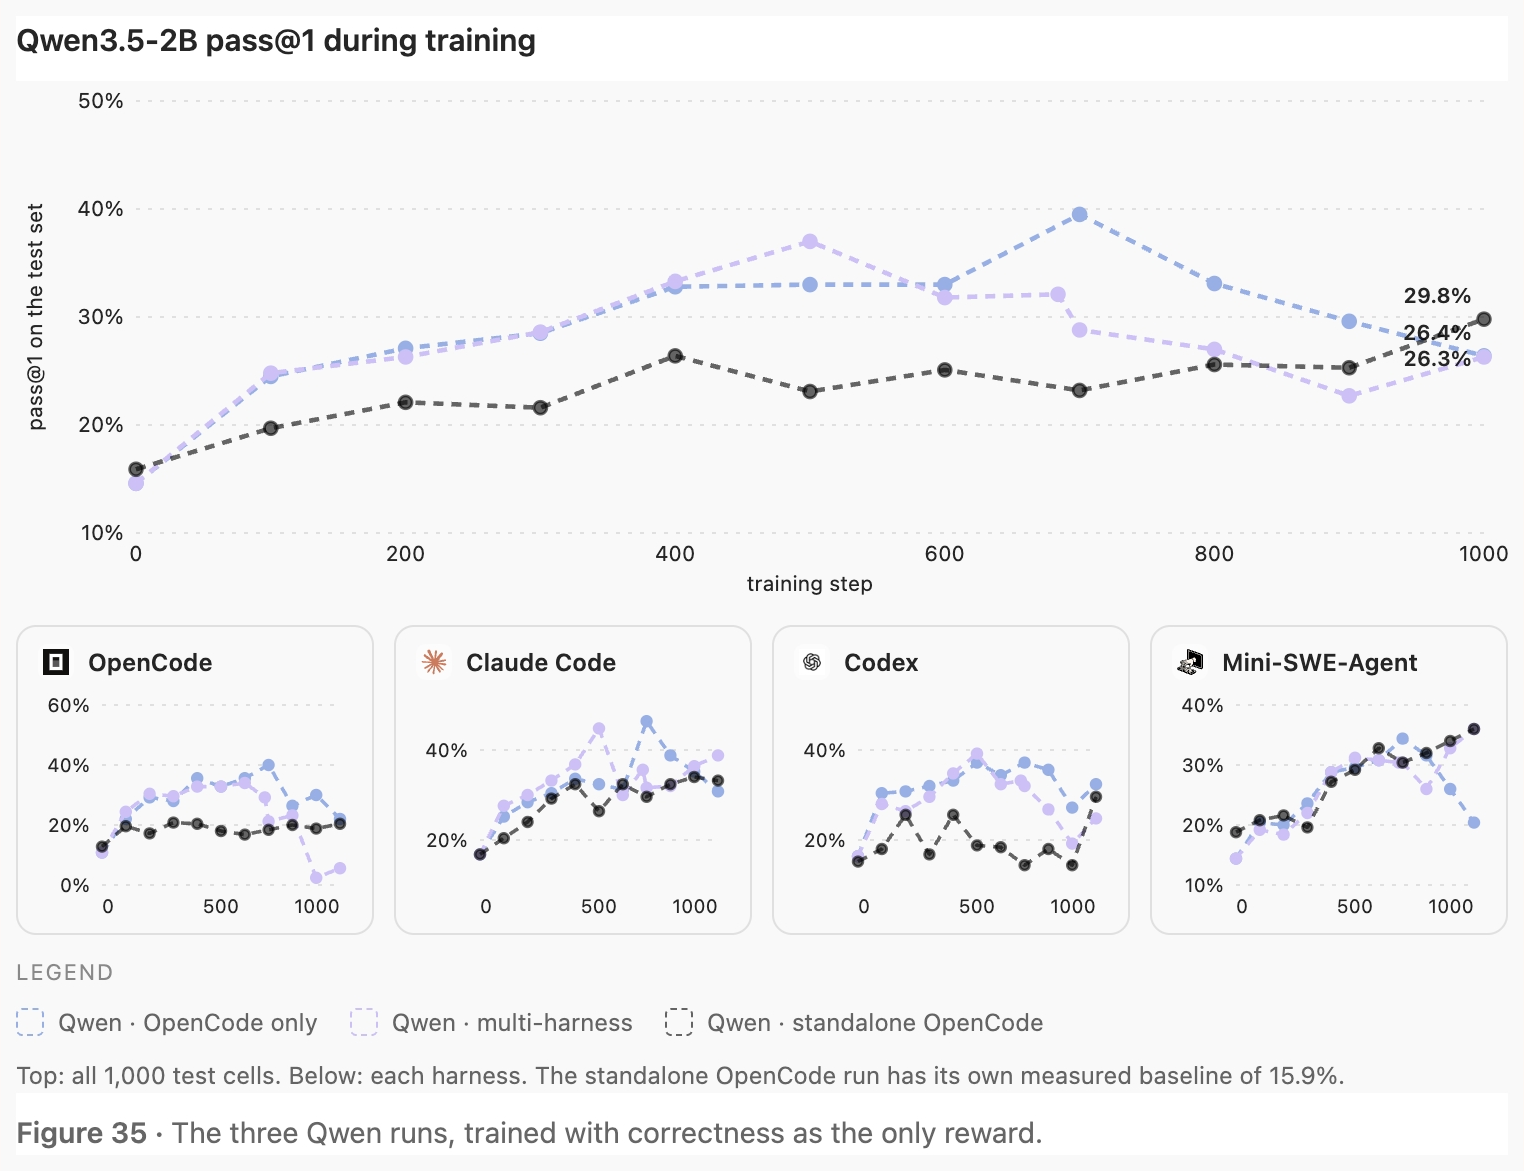
Qwen 测试准确率先上升:多框架在第 500 步附近约 37%,单框架第 700 步附近约 39.5%;之后到第 1,000 步都回落到约 26%。另一个 standalone 设置终点约 29.8%。
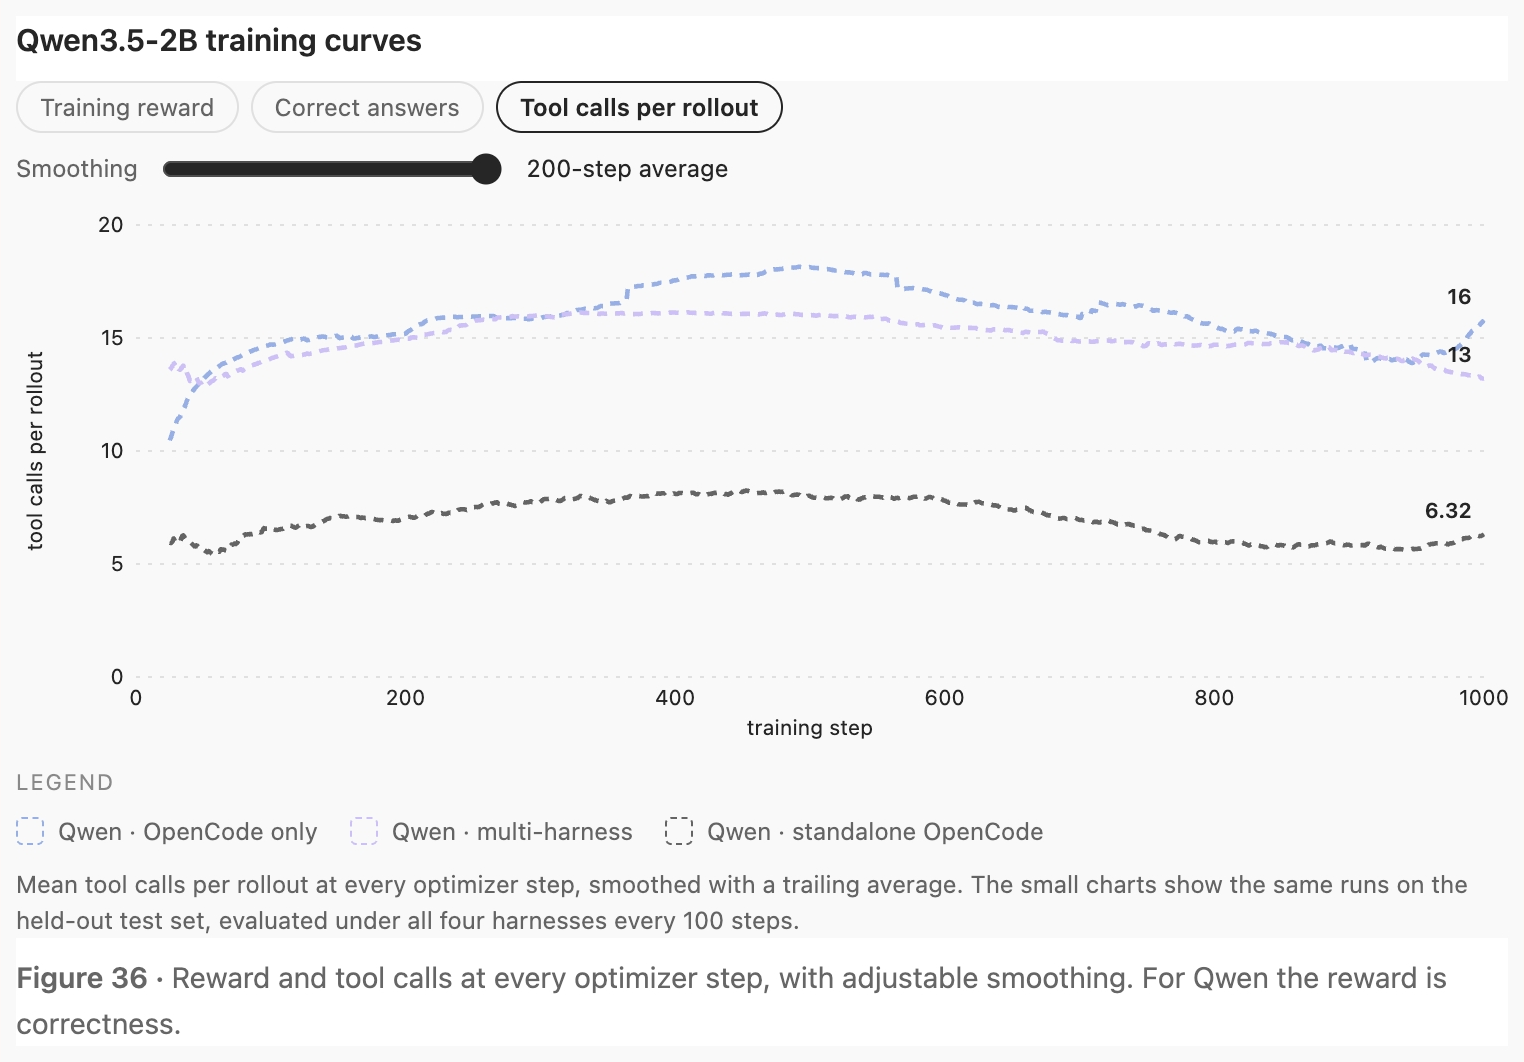
切换训练指标,可以看到工具调用和提交行为的变化。失败并不是一句“模型不够大”就能解释。
作者找到一个明显的预算差异:多框架训练允许的输出 token 上限为 16,384,而评测只允许 4,096。随着训练进展,超过评测上限的格子从 9 增到 556/1,000。模型可能学会训练时允许、评测时做不完的流程。
OpenCode 的工具调用还从约 16 降到约 3;单框架另一条记录却从约 17 增到约 21,提交比例从约 69% 降到约 41%。所以“调用次数减少”本身也可能意味着不再完成必要操作,必须同时看正确率和终止状态。
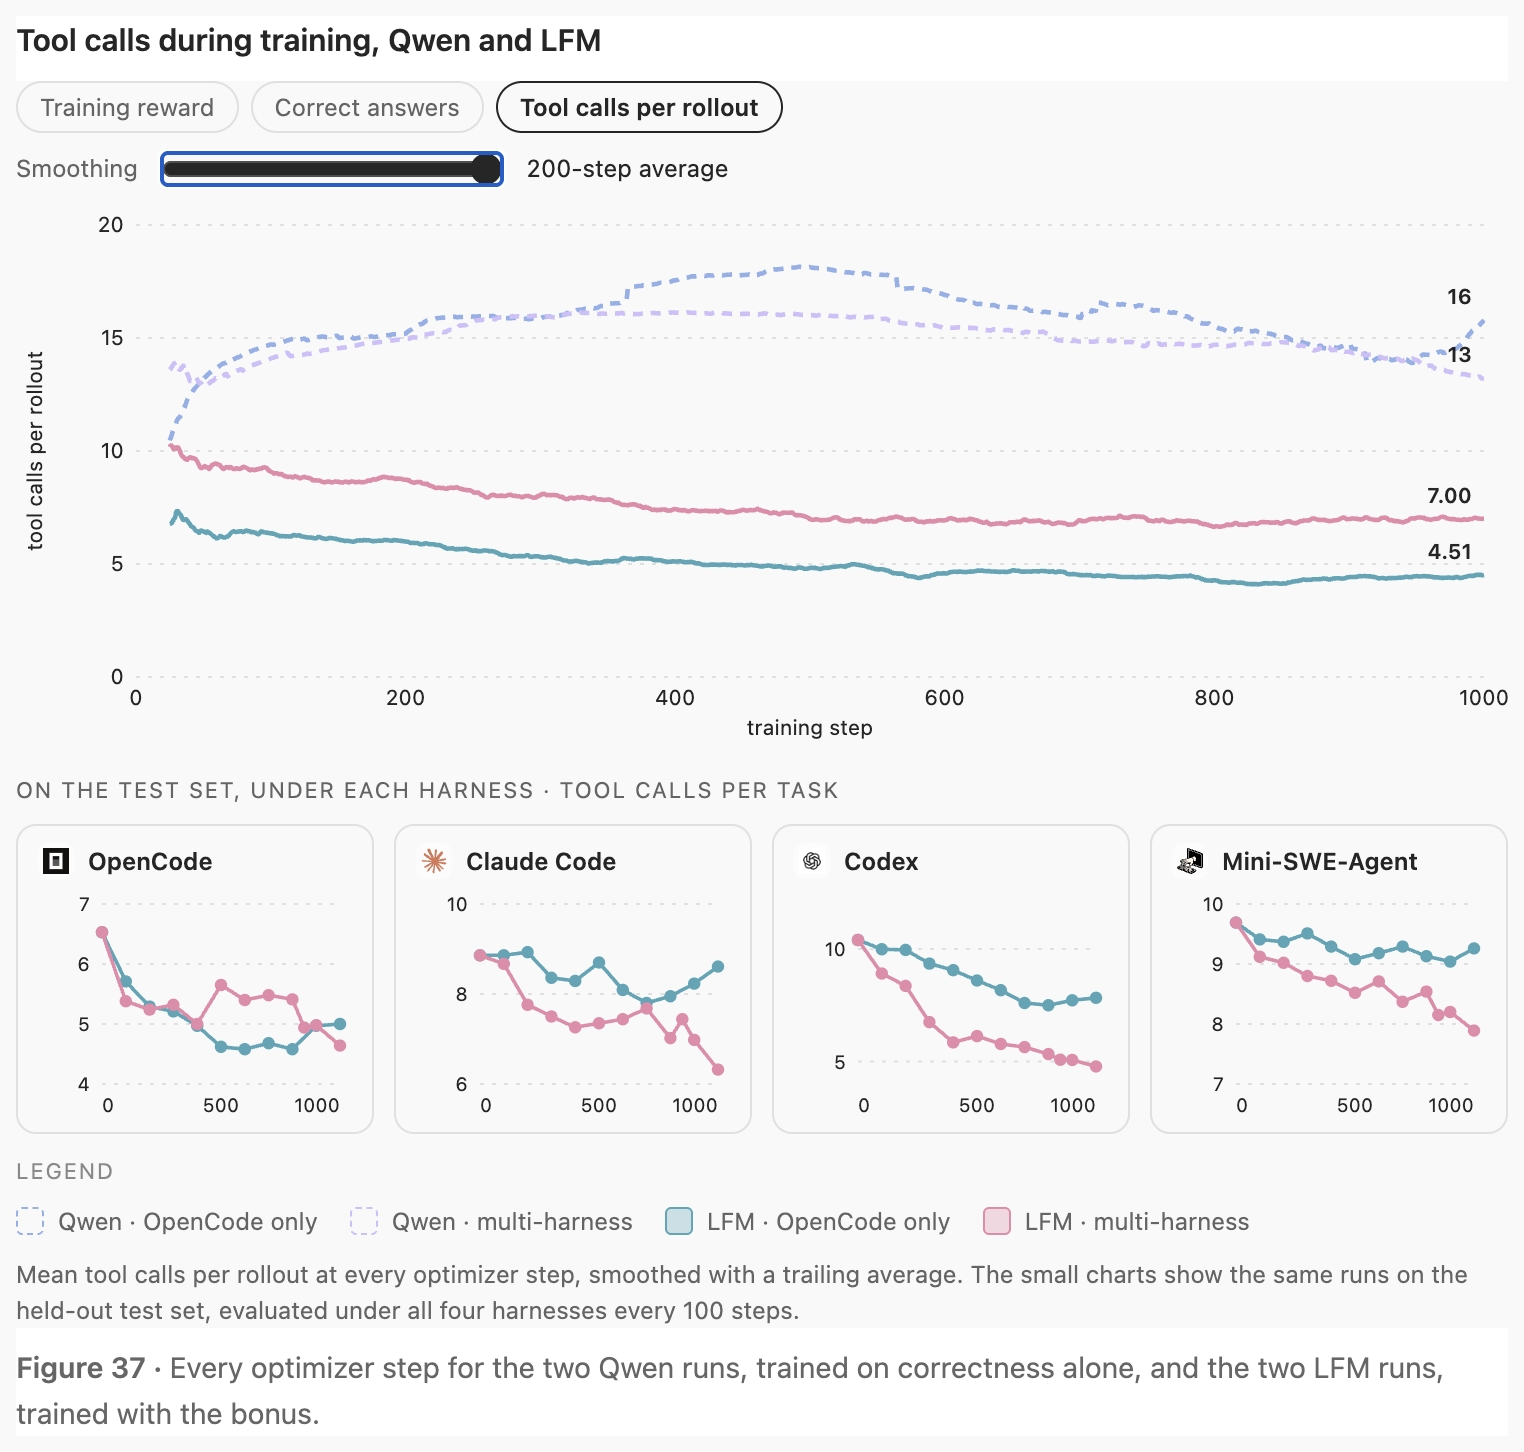
模型间工作量曲线展示若干行为如何变化。它帮助寻找问题,并不单独识别因果。视频的指标和滑块切换保持原网页显示。
此外,第 684 步恢复训练时有一个重复旧任务的 bug,但下降在约第 500 步已经开始,所以不能把它当成全部原因。
还有学习信号稀疏:约 35%–58% 的步没有组内奖励对比。Claude Code 占约四分之一 rollout,却贡献约 77% 的训练行、35% 的监督 token。不同计量单位揭示不同的不均衡。
后来继续用新困难数据没有救回这条轨迹。LFM 方案同时更换了模型、奖励、任务池并对齐输出预算,结果更好;由于同时改变多项因素,无法从这些运行中把每一项的单独贡献拆出来。
十一、读完以后,真正应该带走什么
第一,选择 AI 工具时,评价对象应是“模型+运行框架+任务+预算”。只报模型名字和一个分数,容易遗漏足以改变结论的工作条件。
第二,多步强化学习不仅需要最后答案,还需要可信的行动记录。文字、token、采样概率、工具结果和奖励之间的对应关系,是方法能否成立的一部分。
第三,训练成功不只是让曲线向上。奖励是不是鼓励了正确目标,训练和评测预算是否一致,失败是否被错误算成答错,框架间数据暴露是否失衡,都能改变模型最后学到什么。
这篇工作的强处,是把真实 harness 接到同一条可审计的训练链,并公开成功与失败数据。它的限制也同样清楚:特定数据分析任务、较小模型、每种设置单次运行、暴露和计算不等、检查点选择存在偏好。
因此,最稳妥的结论是:跨框架训练是一个有实际证据、值得继续研究的方向;当前结果展示了可行性与局部收益,还不足以建立普遍排名。
术语翻卡:十二个关键词
点击卡片翻面看解释
自测五题
点题目展开答案
对。多框架训练终点约 54.2%(起点约 42.18%);只在 OpenCode 训练的单框架组终点约 52.3%。
对,约 31.1%。但注意:这不是所有测试题都省 31%,也不是运行时间或 API 账单省 31%。
错。每种设置只运行一次,作者认为这个小差距仍在噪声范围内,不能写成统计证明的胜出。
对。多框架组按组分配四种 harness 之一,不在同一组里混入不同 harness,以免把框架差异当成行动优势。
对。超评测上限的格子从 9 增到 556/1,000——模型可能学会了训练时允许、评测时做不完的流程。
补充:网页中的全部框架标识
以下标识也属于原网页可见的图像资源,全部保留。它们帮助识别生态表中的程序,不是这些组织为本文章背书,也不表示每个程序都参与了核心训练。SVG 标识保留源文件,另用网页渲染显示副本供静态排版。

来源图 ID:logo-claude-code。claude-code 的原始项目标识,用来对应原站生态图中的名称;它只证明标识来源,不证明训练效果或背书。
来源图 ID:logo-codex。codex 的原始项目标识,用来对应原站生态图中的名称;它只证明标识来源,不证明训练效果或背书。
来源图 ID:logo-gemini-cli。gemini-cli 的原始项目标识,用来对应原站生态图中的名称;它只证明标识来源,不证明训练效果或背书。
来源图 ID:logo-goose。goose 的原始项目标识,用来对应原站生态图中的名称;它只证明标识来源,不证明训练效果或背书。
来源图 ID:logo-hermes。hermes 的原始项目标识,用来对应原站生态图中的名称;它只证明标识来源,不证明训练效果或背书。
来源图 ID:logo-kimi-cli。kimi-cli 的原始项目标识,用来对应原站生态图中的名称;它只证明标识来源,不证明训练效果或背书。

来源图 ID:logo-opencode。opencode 的原始项目标识,用来对应原站生态图中的名称;它只证明标识来源,不证明训练效果或背书。

来源图 ID:logo-openhands-sdk。openhands-sdk 的原始项目标识,用来对应原站生态图中的名称;它只证明标识来源,不证明训练效果或背书。
来源图 ID:logo-qwen-coder。qwen-coder 的原始项目标识,用来对应原站生态图中的名称;它只证明标识来源,不证明训练效果或背书。

来源图 ID:logo-swe-agent。swe-agent 的原始项目标识,用来对应原站生态图中的名称;它只证明标识来源,不证明训练效果或背书。
来源图 ID:logo-terminus-2。terminus-2 的原始项目标识,用来对应原站生态图中的名称;它只证明标识来源,不证明训练效果或背书。
来源图 ID:logo-trae-agent。trae-agent 的原始项目标识,用来对应原站生态图中的名称;它只证明标识来源,不证明训练效果或背书。
来源图 ID:og-image。原站用于链接分享的封面资源,仅作补充保存,不是实验数据图。
来源与阅读路径
本文主来源:FineEnvs 原交互文章。完整机制、实验限定、图表数据及折叠内容,以该版本原文和本地保存的源码快照为准。
方法与复现入口:OpenEnv、OpenEnv Harbor 文档、Harbor、TRL 异步 GRPO 示例、FineEnvs 训练教程。本文所列实现状态有日期边界,安装时请核对官方当前文档。
外部模型—框架搭配图署名 Joel Niklaus,出处由原网页提供。八张报告摘录的作者、页面和原始链接见对应图注与本地来源台账。本文中文正文为解释性重写;未将译述包装成作者逐字原话。
本文配图和演示不构成独立复现实验。原图、源程序、报告摘录的权利归各自权利人;公开代码许可不能自动外推到第三方论文图和商标。正式发布前,由发布者核对使用条件与署名,并终审文章与全部视频。