一句话,让实验室自己干活:读懂 AutoDNA
论文:Wu M, Wang Z, Wang J 等(通讯作者 Wang F、Fan C、Chen H),An AI-native experimental laboratory for autonomous biomolecular engineering,arXiv 2507.02379,上海交通大学。预印本,尚未经过同行评审。
一、先看一个画面
想象你对电脑说:“帮我把霍金的一句名言存进 DNA 里。”
然后,除了中途有人补充试剂,再没有人动手。机器自己设计方案、写控制代码,指挥 25 台仪器把它合成出来、存好。之后你再说一句“把它读出来”,它就测序、解码,读回的内容和写进去的一致。从写入到读出,整个流程(含冰箱保存)用时 162.9 小时,共 9,365 个硬件操作步骤。
这是上海交通大学计算机与化学两个团队合作搭建的 AutoDNA——一个“AI 原生”的自主实验室。要看懂它厉害在哪,我们得先补一点背景。
二、补课:DNA 为什么能存数据
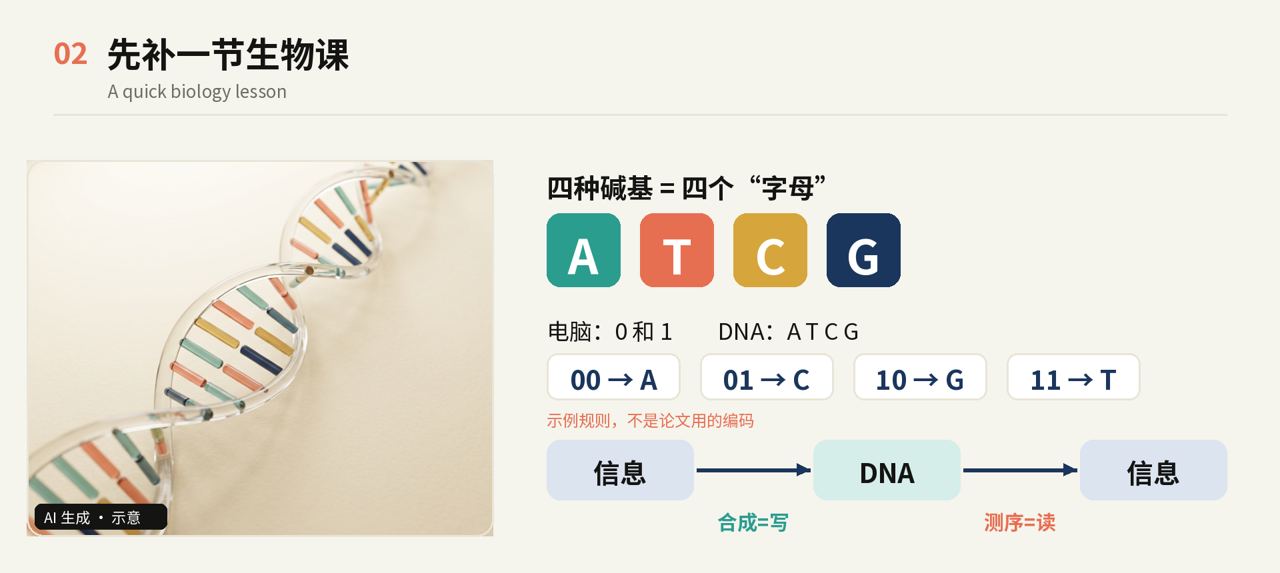
DNA 是生命的说明书,只用四种“字母”书写:A(腺嘌呤)、T(胸腺嘧啶)、C(胞嘧啶)、G(鸟嘌呤),也就是四种碱基。
电脑用 0 和 1 存信息;DNA 用四个字母存信息。只要定一套对应规则——比如每两位二进制对应一个字母(00→A、01→C……,这只是举例,不是论文用的编码)——一段文字就能变成一串 DNA 序列。
- 写入 = 合成:按设计好的顺序,把字母一个个接成 DNA 链。
- 读取 = 测序:用仪器把 DNA 上的字母顺序读出来。
每一步都需要精确的温度、以微升计的液体、许多台仪器接力配合,还要不断调整条件。这正是核酸实验难以全自动化的原因。
三、以前的“机器人化学家”缺了什么
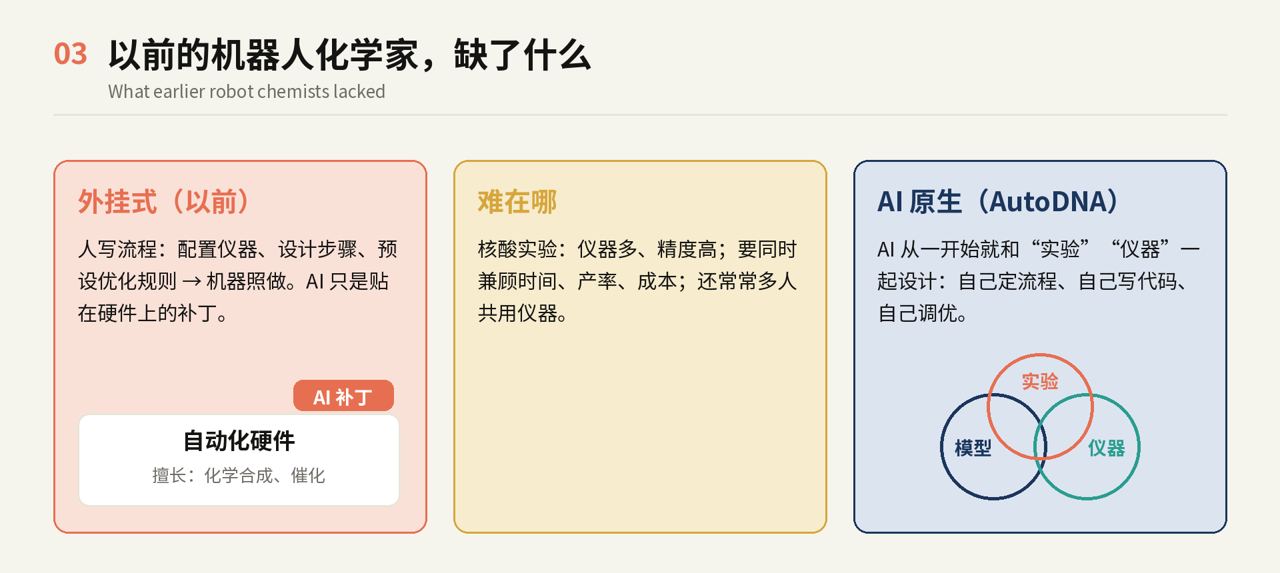
“机器人化学家”并不新鲜,已有平台能用自然语言下指令、自动做有机合成。但论文指出,它们普遍有个短板:看不懂实验本身。仪器要人来配置,步骤要人来设计,怎么优化也要人先定好规则。
作者把这叫“外挂式”(add-on)架构:机器学习模型只是贴在现成自动化硬件上的补丁。所以这类系统擅长目标单一、流程固定的任务,比如化学合成和催化。
核酸实验正好相反:要同时兼顾时间、产率、成本多个目标,要协调多台高精度仪器,还常常是多人共用一套设备。决策空间一下子变得巨大。
AutoDNA 的回答是“AI 原生”:让 AI 模型、实验和仪器从一开始就协同设计(co-design),AI 能真正理解“实验要什么”和“仪器能做什么”。
四、六位 AI 组成的“后厨”
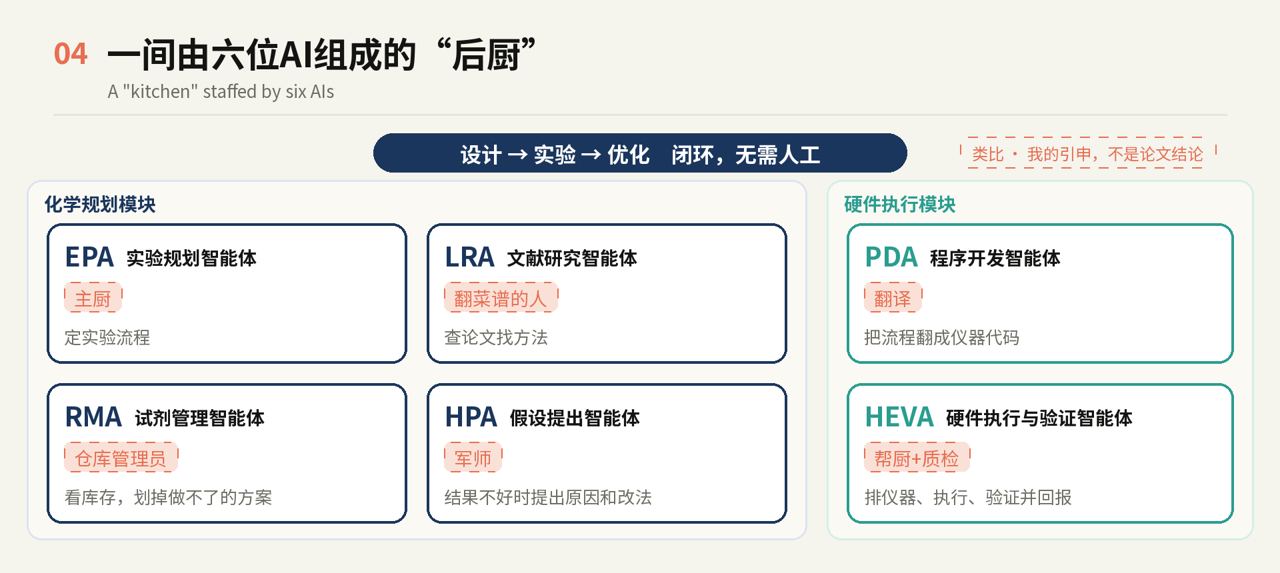
【类比 · 我的引申,不是论文结论】把 AutoDNA 想成一间后厨,六位厨师各司其职。表格里“类比”一列都属于这个比喻。
AutoDNA 分两个模块,共六个由大语言模型驱动的智能体(agent),彼此用自然语言交流:
化学规划模块 | 智能体 | 职责 | 类比 | |—|—|—| | 实验规划智能体 EPA | 按用户需求设计实验流程,总指挥 | 主厨 | | 文献研究智能体 LRA | 从科学文献里检索关键方法 | 翻菜谱的人 | | 试剂管理智能体 RMA | 管库存,筛掉做不成的方案 | 仓库管理员 | | 假设提出智能体 HPA | 结果不理想时提出原因与改进假设 | 军师 |
硬件执行模块 | 智能体 | 职责 | 类比 | |—|—|—| | 程序开发智能体 PDA | 把流程翻译成仪器能执行的代码 | 翻译 | | 硬件执行与验证智能体 HEVA | 调度仪器、执行、验证结果并反馈 | 帮厨兼质检 |
它们组成一个闭环:设计 → 实验 → 优化,一圈圈转,直到达到用户设定的目标,全程不需要人插手。
五、关键发明:把仪器拆成“积木”
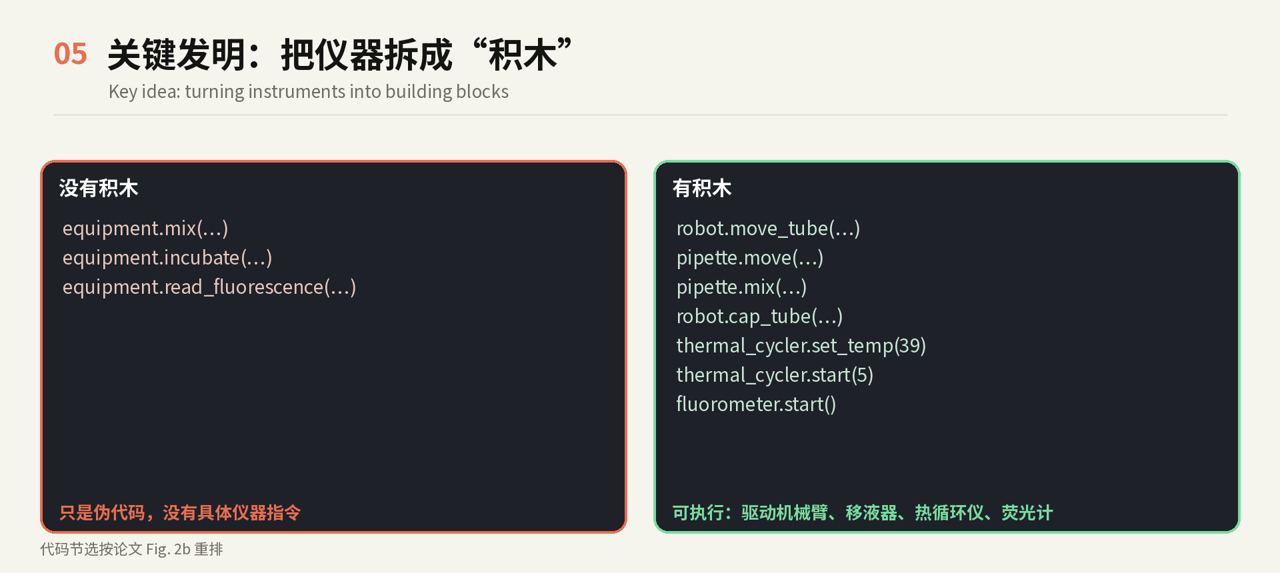
AI 会说话,仪器却听不懂人话。团队的解法叫原子服务(atomic services):程序开发智能体读仪器的技术文档,把每台仪器的功能拆成一块块小积木。例如热循环仪被拆成两块:
set_temp:设定温度start:开始反应
每块积木是一个 Python 对象,附带自然语言说明,正好对上大语言模型“读文字”的长处。
论文做了对比:没有积木时,AI 只写得出
equipment.mix(…)
这类空洞的伪代码;有了积木,它写出了
robot.move_tube(…)、pipette.mix(…)、thermal_cycler.set_temp(39)
这样能真正驱动机械臂、移液器、热循环仪和荧光计的代码。
六、实验一:核酸检测
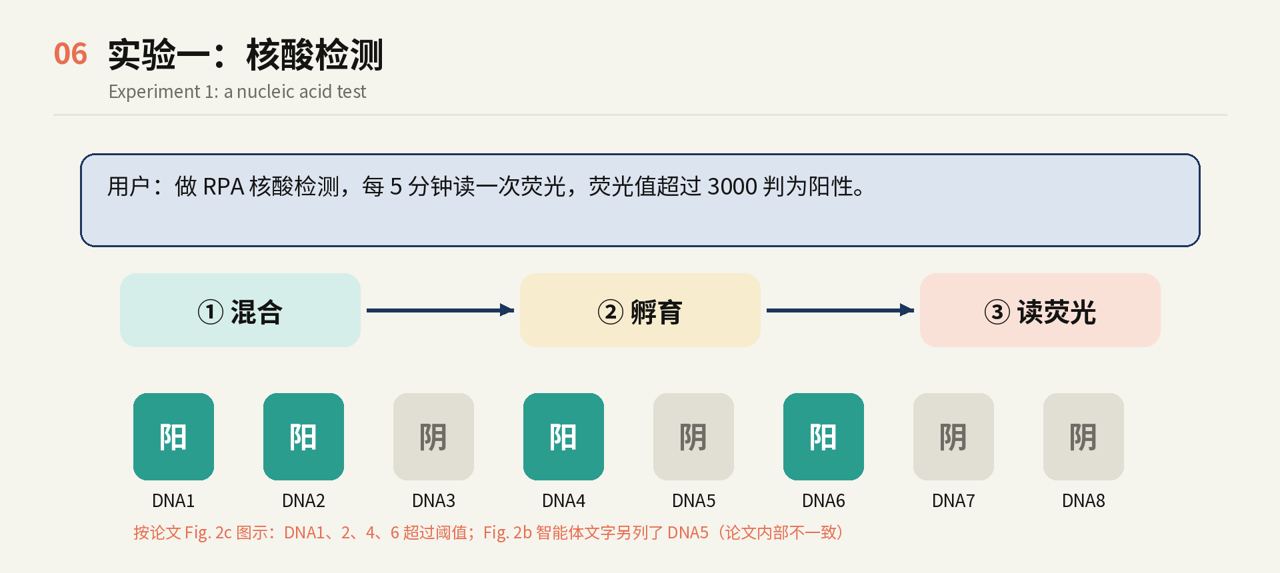
RPA(重组酶聚合酶扩增)是一种常用的核酸检测方法:重组酶带着引物找到目标 DNA,聚合酶沿着它复制,不需要反复升降温,恒定温度下就能快速扩增。扩增越多,荧光越强。
用户只说了一句:做 RPA 检测,每 5 分钟记录一次荧光,荧光值超过 3000 判为阳性。
AI 给出三步:混合、孵育、读荧光。两个细节很有意思:
- 它自己推断孵育时要盖上管盖、防止蒸发,并调用了机械臂的盖管操作。
- 它自己查出代码里漏了一步加样——否则仪器会对着空孔加热和读数。
8 个样本中,AutoDNA 测得的荧光值与人工实验统计上相当,阳性判定一致。
细心读者会发现:论文 Fig. 2c 图中只有 DNA1、2、4、6 超过阈值,而 Fig. 2b 里智能体输出的文字列了 DNA1、2、4、5、6。这是论文内部的一处小矛盾,正式发表时值得作者核对。
七、实验二:让 AI 自己优化 DNA 合成
酶法从头合成 DNA 被视为下一代合成技术。TdT 是一种特别的聚合酶:不需要模板,能直接往 DNA 链末端加核苷酸。每一轮分两步:工程改造的 TdT 酶给 DNA 链末端接上一个戴着“保护帽”的核苷酸(可逆终止剂,保证一次只接一个);然后脱保护摘掉帽子,准备下一轮。
难点在于:缓冲液、表面活性剂、各成分浓度、反应时间,可调的旋钮太多,搜索空间巨大。
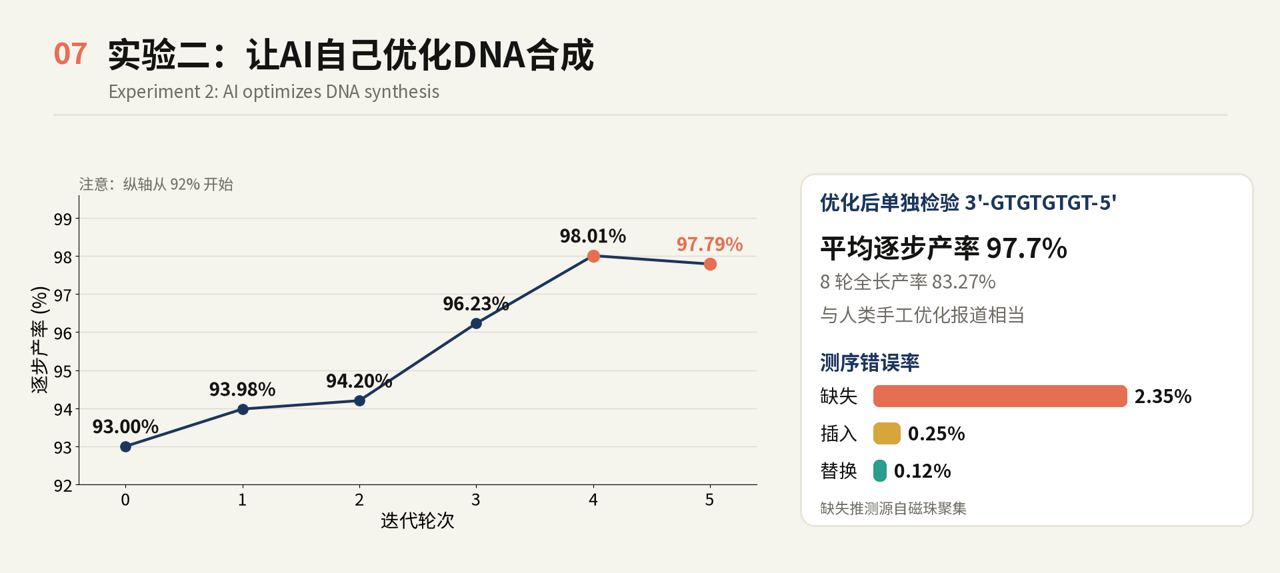
用户的目标有两个:产率最高、时间最短。AI 的优化轨迹如下(逐步产率):
| 迭代 | 决定 | 逐步产率 |
|---|---|---|
| 0 | 起点(lysis 缓冲液洗涤) | 93.00% |
| 1 | 改用 B&W 缓冲液 | 93.98% |
| 2 | 加表面活性剂 Tween-20 | 94.20% |
| 3 | 提高辅因子 CoCl₂ 浓度 | 96.23% |
| 4 | 提高 TdT 酶和可逆终止剂浓度 | 98.01% |
| 5 | 缩短延伸孵育时间 | 97.79% → 产率下降,停止 |
注意第 5 轮:为了“时间最短”去缩短反应,结果产率掉了,AI 主动停手。这说明它在两个目标之间做了取舍。
优化完成后,团队又用它单独合成一段 8 个碱基的检验序列(3’-GTGTGTGT-5’),平均逐步产率 97.7%,与此前人类手工优化报道的结果相当。这是一次新的测量,所以和优化曲线上的 98.01% 不是同一个数。
小知识:“逐步产率”是每接一个字母的成功率,“全长产率”是 8 个字母全部接对的比例。每步 97.7%,接 8 次大约是 0.977⁸ ≈ 83%,与实测的全长产率 83.27% 吻合。
纳米孔测序给出的各类错误率:缺失(漏字母)约 2.35%,插入 0.25%,替换 0.12%,缺失最多;作者推测缺失主要来自磁珠聚集。
八、实验三:一台机器同时服务好几个人
单用户场景:AI 在优化时生成了两套相似的可行流程。执行智能体把它们合并,用多通道移液器一次处理一排管子。总时间从 1,434.7 分钟降到 398.7 分钟,即 3.60 倍。
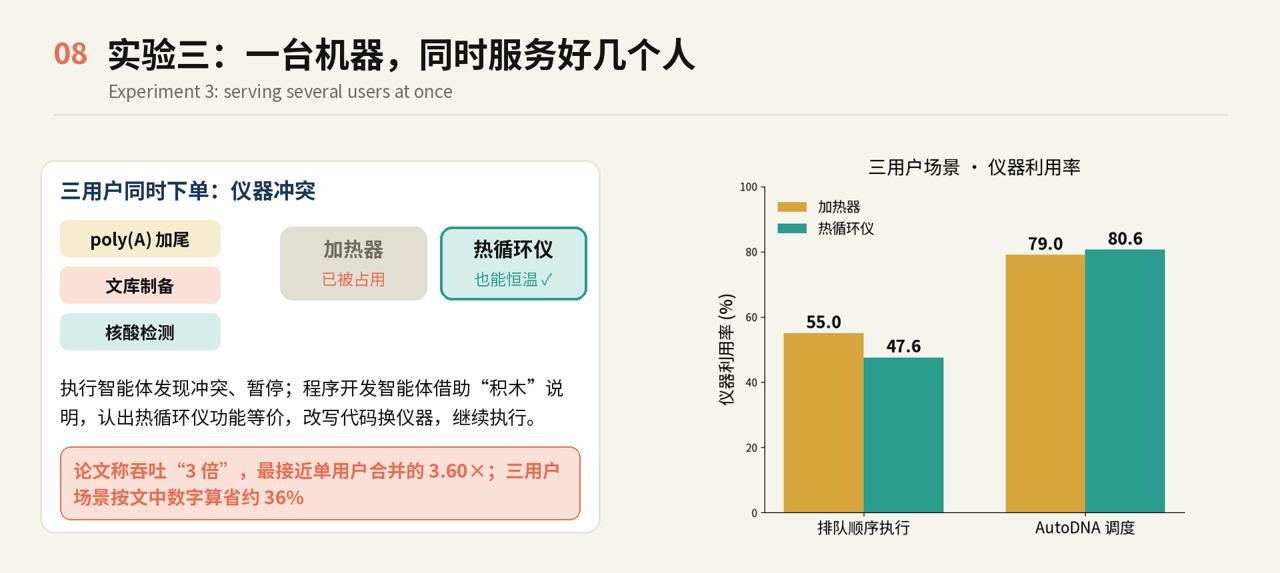
三用户场景:三个人同时提交 DNA poly(A) 加尾、文库制备和核酸检测。文库制备原本要用加热器,可加热器正被加尾实验占着。程序开发智能体借助“积木”说明,认出热循环仪也能做恒温孵育,改写代码换了仪器。
- 总时间:472.7 → 303.9 分钟,省下 168.8 分钟(按文中数字算约 36%)
- 加热器利用率:55.0% → 79.0%;热循环仪:47.6% → 80.6%
澄清:论文引言和讨论部分说调度让吞吐“提升 3 倍”,但没写明对应哪组数据。文中最接近的数字是单用户合并的 3.60 倍;三用户场景按文中数字算是省下约 36% 的时间,不是 3 倍。(这一对应关系是我们的判断,不是论文原话。)
九、大考:DNA 数据存储全流程
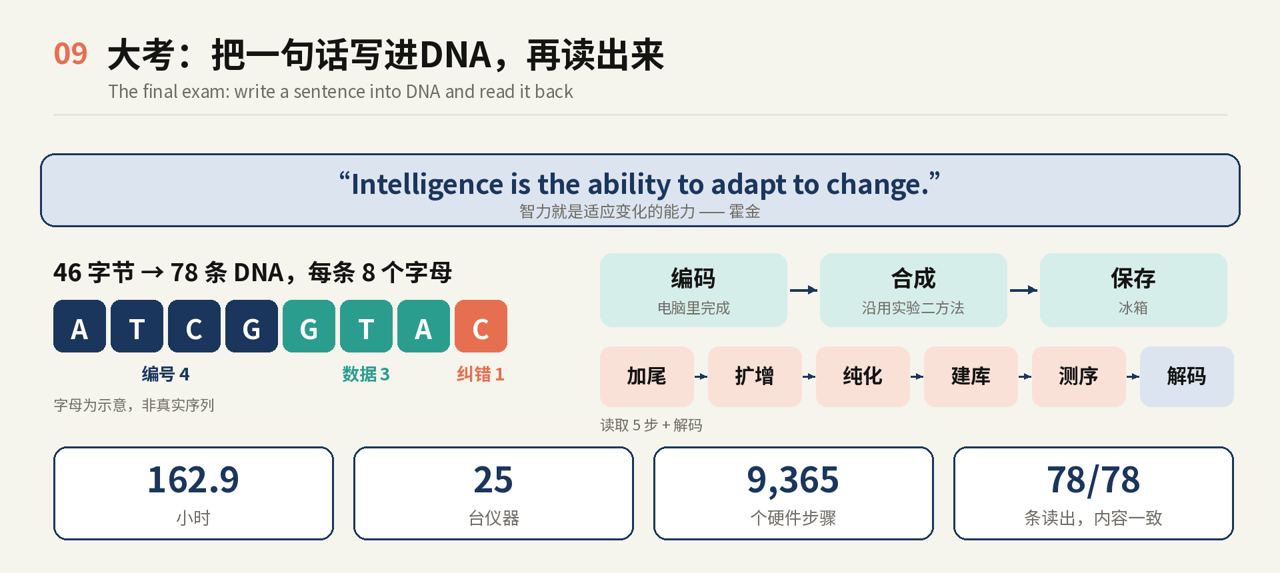
完整流程五步:编码(数字→碱基序列)、写入(合成)、保存、读取(测序)、解码。
- 内容:霍金名言 “Intelligence is the ability to adapt to change.”(智力就是适应变化的能力),共 46 字节。
- 编码:AI 设计编码方案,切成 78 条 DNA,每条 8 个碱基——4 个做编号(索引),3 个存数据,1 个纠错。
- 写入:直接调用实验二已归档的酶法合成流程;合成后放进冰箱保存。
- 读取:末端加尾、扩增、纯化、文库制备、测序,再解码。
全程 162.9 小时、25 台仪器、9,365 个硬件步骤(每调用一次原子服务算一步),除补充试剂外无人工干预。78 条全部读出,解码内容与写入一致。主要错误仍是缺失。
十、冷静看:做到了什么,还没做到什么
它做到的 - 从自然语言请求到完整实验;平台支持合成、扩增、转录、测序等核酸基础功能,文中实测了核酸检测、酶法合成、多人调度和 DNA 存储。 - 不靠人预设规则,自己查文献、提假设、调参数,产率追平专家。 - 多人共享仪器时会动态调度、换用等价仪器。
还没做到的 1. 预印本,结论尚未经过同行评审。 2. 成绩是追平人类专家,而不是超越。 3. 规模很小:只存了 46 字节,每条 DNA 8 个碱基,离“DNA 硬盘”还很远。 4. 仍需人手:试剂要人补;“漏字母”这个主要错误尚未解决。 5. 论文没有写明具体用的是哪个大语言模型。
为什么值得关注:作者的愿景是科学即服务(science-as-a-service)——让不懂实验的人,也能用自然语言让实验室替自己完成实验。不过论文还没有让真正的非专业用户来测试;比如 RPA 示例里,阈值和读数间隔仍是用户给出的专业参数。作者下一步想把它推向生物材料发现等更具探索性的领域。
留一个问题:如果实验室能自己做实验,科学家最重要的能力会变成什么?是提出好问题、判断结果真假,还是别的?