01
分工
每个智能体认领一个基因扰动
大任务按基因切开,几千份同时开工。
2026 年 10 月 · 给临床研究者的速读
五家公司 · 六项前沿 · 一条新药研发链
图片来源:NVIDIA 官方
总览地图 · 点击节点跳到对应章节
🧠 ① 读懂数据 · OpenAI · 2026-10-21
把一个超大实验拆成几千份,每个 AI“研究助理”只负责一个基因,查文献、写解释,最后汇总成一本“推理图谱”。
OpenAI 与 PerturbAI、Scripps Research 合作,用 GPT-Rosalind 驱动的数千个,在 32 分钟内分析了“全脑 CRISPR 图谱”(whole-brain CRISPR atlas)。这份图谱记录了(基因敲除)如何影响小鼠全脑各类细胞,涉及数百万个细胞。研究团队估计,同等的人工逐个扰动分析加文献综述需要数月到一年。
智能体复现了人工分析的发现,也找到了新线索;它们对新颖性的评估与盲评的人类专家一致。
对照实验固定了模型与资源。拖动滑块看两种做法引用文献数的走势;只有最大工作量处的 11 与 700+ 是真实数据,其余为平滑示意。
案例一
两个基因共同调控 ,在多数神经元中敲除效果相似。
案例二
DCTN1 突变导致 Perry 综合征(帕金森样神经退行病);它参与神经元内的“货物运输”。
“我们建造细胞图谱,是为了让其他科学家做出我们没想到的发现。”
Sarah Teichmann,剑桥大学,人类细胞图谱联合创始主席
神经元功能与胆固醇代谢之间可能存在联系。
Tomasz Nowakowski(UCSF)对 DCTN1 线索的评论,大意
01
分工
大任务按基因切开,几千份同时开工。
02
分析
从全脑 CRISPR 图谱中读出该扰动在不同细胞类型中的效应。
03
检索与解释
每个智能体只读与自己基因相关的文献,所以总覆盖面远大于单个智能体。
04
汇总
每条记录:基因 → 细胞效应 → 文献 → 可能机制。
结果是待实验验证的线索,不是结论。专家盲评把关质量,OpenAI 的原话是“科学家仍处于发现的中心”。
🧬 ② 预测结构 · Microsoft Research · 2026 年 10 月
以前的结构预测像给蛋白质拍一张证件照;BioEmu-2 给出一组“连拍”,即同一分子可能出现的多种姿态()。
单一结构:只告诉你分子“最可能”长什么样。
示意图,非真实分子。
| 类型 | 基于的全原子打分模型(diffusion-based all-atom score model) |
|---|---|
| 输入 | 生物分子序列;可选 、接触约束、方法条件 |
| 输出 | 通过反向扩散采样得到的全原子 3D 结构系综 |
| 支持 | 多链复合物、配体、核酸;可用原子间距离信息引导 |
| 训练时间 | 2026 年 8–9 月 |
| 评估 | Boltz-1 测试集上的 RMSD、TM-score、lDDT、物理合理性、界面 DockQ;多构象采样基准;分子动力学(MD)模拟基准;>1,500 token 大复合物 |
MSR_ 开头为微软自产分子动力学(MD)轨迹。
01
输入
MSA 提供进化信息;接触约束或距离信息告诉模型哪些原子应当靠近。
02
从噪声出发
打分模型在每一步指出原子该往哪个方向移动。
03
多次采样
多次采样的结果合起来就是系综;训练中的 MD 轨迹教会模型“分子会动”。
模型卡写明:输出是“计算假说,不是实验测量”。明确列出禁止用途(见上方“不能做”),定位为研究模型,不建议商用。
🧪 ③ 设计分子 · NVIDIA · 2026-10-21 · GTC Berlin
不再满足于找到大自然已经造好的蛋白,而是给出需求和约束,让模型生成并反复迭代出全新蛋白。
NVIDIA 与华盛顿大学蛋白质设计研究所(UW Medicine IPD)推出 RFD4-Proteina,一个 开源模型,结合可编程蛋白设计与搜索能力,可按分子输入、约束和打分目标生成并迭代设计。
在研究草稿的测试中,它在四类基准上的计算设计成功率与生成吞吐量均高于对比基线。
官方只说“成功率与吞吐量均超基线”,未公布具体分数,这里也不填数字。
点一个节点,看它在生态里做什么。
Amazon Bio Discovery · Anthropic Claude Science · Benchling · Databricks · Google Cloud · Hugging Face · Nebius · OpenAI · Tamarind Bio
Nemotron 智能体协同计划;CUDA 加速剂量计算做患者特异模拟;Holoscan 连接实时传感数据。背景:预计到 2050 年全球每年约 3,500 万人确诊癌症。
NVIDIA 给出的市场背景数字。
01
定需求
要结合什么靶点、保留哪些口袋、骨架有什么限制。
02
生成
设计过程受约束条件引导,而不是自由发挥。
03
打分搜索
搜索能力让模型围绕目标反复改进,而不是一次出稿。
04
分发
连向 Benchling、Danaher 等实验与工作流平台,进入真实实验环节。
基准结果来自研究草稿,是计算成功率;设计出的蛋白仍需实验验证。
🔬 ④ 湿实验验证 · Google Research · 2026-10-16
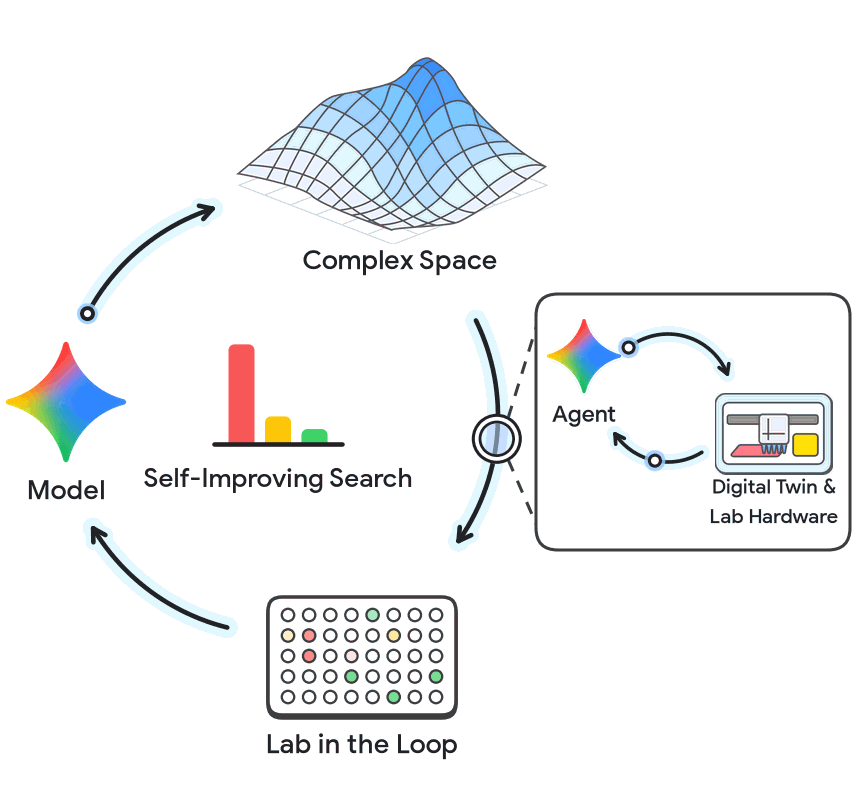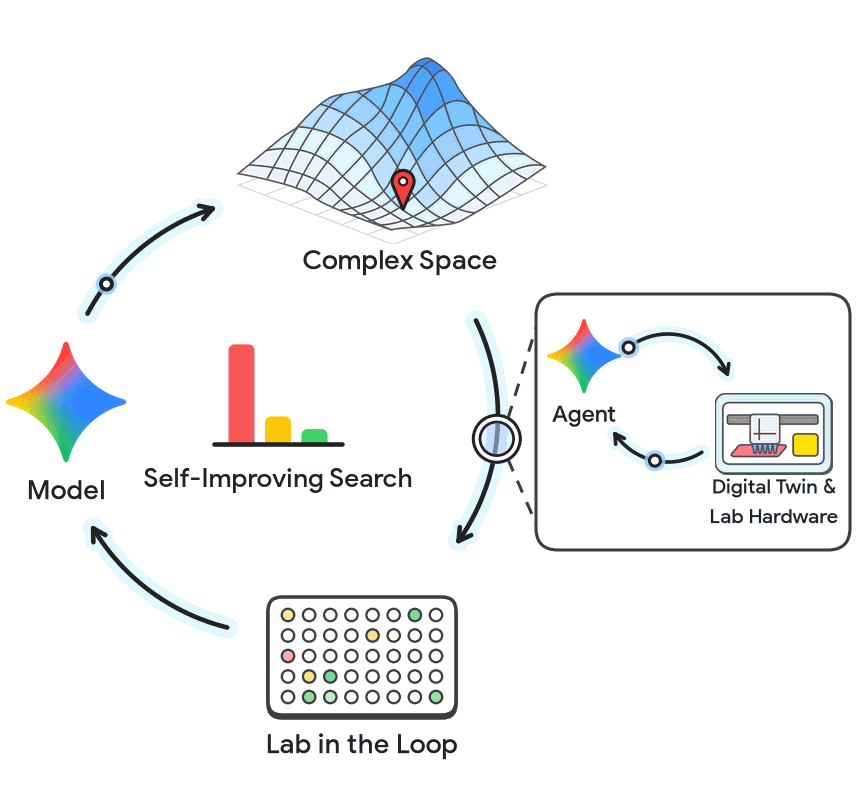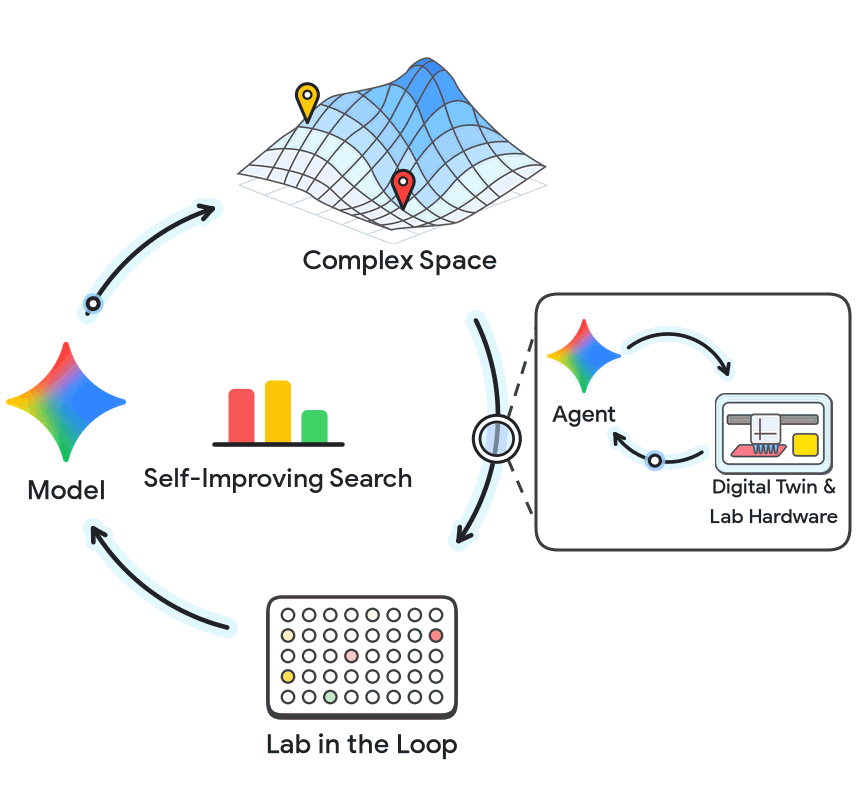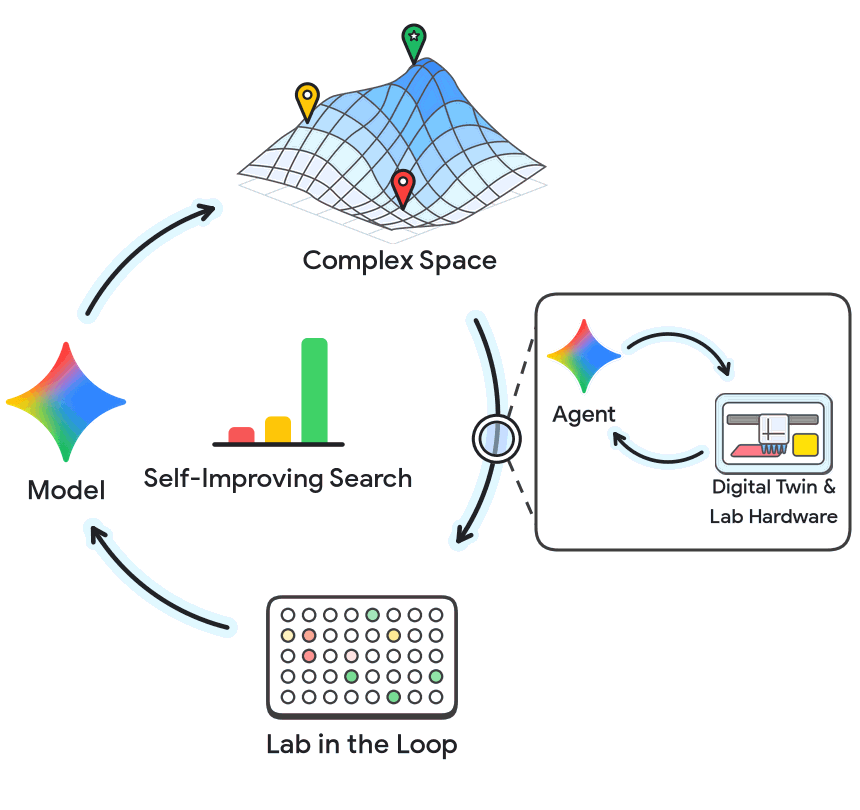
AI 不只是“想”,而是在机器人实验台上做实验、读结果、改设计,再做下一轮。
搜索空间大得离谱:一个 100 个氨基酸的蛋白就有至少 20100 种可能序列。两大难题卡着整条链:前沿模型对 3D 几何和物理状态的推理不可靠;真实跟不上 AI 的设计速度,读数成为瓶颈。Google 用三项研究分别啃这两块骨头。
VERID(VERified Infrastructure for Discovery Laboratories)基于开源 PyLabRobot,实时追踪机械臂几何、每孔体积、试剂与枪头库存,相当于实验台的。
设计 → 合成 → 磁珠筛选 → 测序,智能体每轮根据失败原因改规则。是能特异结合靶标的短 DNA/RNA。
点击折线上的数据点,看那一轮发生了什么。
α-凝血酶只公布了第 3 轮特异性 98.5%,前两轮特异性未公布,故不作图。
筛选用酵母表面展示 + 高通量筛选。
动画示意闭环节奏,每轮实际耗时 7–10 天。
体系限定为非感染性、无功能增益风险;每条序列都做生物安全筛查;先在数字孪生里模拟再执行;序列与协议由人类审批,并由人类监督运行。原型阶段。
💊 ⑤ 管理研发 · OpenAI 收购 Orchestra Bio · 2026-10-20
新药研发链条长、环节多,一处出问题会层层传导;Orchestra 让智能体盯进度、算影响,人来拍板。
Orchestra Bio 是帮助生物制药团队协调药物开发的平台:人与智能体协作推进药物项目,智能体负责监控和追踪研究与项目进度。它将并入 OpenAI 的 Rosalind:GPT-Rosalind 负责生物化学推理,Rosalind Workbench 连接科学工具与数据。合作伙伴包括 Novo Nordisk 与 Moderna。
美国新药从靶点发现到获批,平均约 10–15 年
阶段宽度不代表实际时长。
商业平台,已收购整合。智能体只负责监控、汇总与比较方案,最终决策由人做出。
🤝 ⑥ 开放协作 · Anthropic · 2026-10-22
Anthropic 免费出模型和工程师,和你的课题组一起干 8–12 周,成果开源。
学术机构、非营利组织、政府实验室的 及其课题组。
10-22
约 11 月上旬
推算
截止后约 14 天
入选后
合作结束
截止日按发布日加约 14 天推算,以官方页面为准。
征集中。申请只用公开信息,不要求提交数据。相关计划:Life Sciences Verification Program;AI for Science(提供 Claude 额度)。
横向对比
点表头排序,或按链条位置筛选。
| OpenAI 分布式智能体 | 10-21 | 读懂数据 | 数千智能体 32 分钟分析全脑 CRISPR 图谱 | 推理图谱与论文公开 | 研究成果,待实验验证 | 专家盲评、科学家主导 |
|---|---|---|---|---|---|---|
| Microsoft BioEmu-2 | 10 月 | 预测结构 | 全原子构象系综 | MIT 开源权重与代码 | 研究模型,不建议商用 | 明确禁止用途清单 |
| NVIDIA RFD4-Proteina | 10-21 | 设计分子 | 可编程蛋白设计 + 搜索 | 开源模型,多平台可用 | 四基准超基线(研究草稿) | 需实验验证 |
| Google 自主湿实验室 | 10-16 | 湿实验验证 | VERID + 闭环设计 | 论文公开 | 原型,人类监督 | 生物安全筛查 + 先模拟后执行 |
| OpenAI × Orchestra | 10-20 | 管理研发 | 智能体协调药物项目 | 商业平台 | 已收购整合 | 人做最终决策 |
| Anthropic 客座研究员 | 10-22 | 开放协作 | 免费合作 8–12 周 | 成果开源 | 征集中 | 申请仅用公开信息 |
日期均为 2026 年;BioEmu-2 官方只写“10 月”,排序时排在最前。
解读 · 编辑观点
AI 正从“提建议”走向“设计-实验-学习”闭环。证据:Google 适配体三轮自我纠错;Danaher 自主实验室里的 AI 共同科学家协调设计与测试。
分工后的智能体群比单一智能体看得更广:同样的模型与资源,11 篇对 700+ 篇引用。
模型开源加跨平台分发:BioEmu-2 用 MIT 许可,RFD4-Proteina 进入 Claude Science 与 OpenAI 等渠道,竞争对手的平台彼此互通。
分布式智能体式的“分工阅读”最先落地,适合系统综述、机制梳理。
Anthropic 计划把临床科学列为五个方向之一,临床课题组可以直接申请。
放疗计划等流程开始用智能体协同规划,如西门子医疗(Varian)× NVIDIA 的自适应放疗。
BioEmu-2 模型卡明确排除临床诊断与治疗用途;其余工具同样只产出待验证的假说。
术语表